KV Cache Engineering for LLM Serving, clearly explained
LLM 服务中的 KV Cache 工程:清晰讲解
5,983 个英文词 · 25 个原文块 · 8 张保存图片
总结
文章解释了 KV cache 为何会增长:模型权重在推理期间大致固定,而缓存会随序列中的每个 token 增长,且默认每个活跃序列都需要独立缓存。以 Llama 3.1 70B 为例,单个 128K-token 序列约需 40 GB 的 BF16 KV cache;四个满长度序列还会增加约 160 GB,尚未计入模型权重和服务开销。缓存既占用 GPU 内存,注意力层生成新 token 时也必须反复读取它。
文章按缓存公式将 12 种技术归类为减少 KV 头数、层数、保留 token 数、表示宽度、每个值的比特数,或减少重复分配与读取。架构方法包括 GQA/MQA、跨层注意力、滑动窗口、MLA、混合循环层和压缩稀疏注意力;服务引擎方法包括查询感知稀疏读取、量化、驱逐、分页、前缀复用和 GPU 外卸。作者特别区分了“减少缓存容量”和“减少注意力读取工作”:稀疏注意力或 Quest 可能减少读取与延迟,但不一定减少常驻缓存。
文中给出多项数字和示例:GQA/MQA 通过共享 KV 头减少存储,Llama 3.1 70B 在 64 个查询头、8 个 KV 头时,128K 上下文约为 40 GB BF16 cache,而相同形状使用 64 个 KV 头时为 320 GB;滑动窗口只保留最近位置;量化可将 BF16 的 16 bit payload 降至 FP8 的 8 bit 或 4-bit 格式,但会引入误差和额外 scale 元数据。CLA、MLA、混合模型及压缩稀疏注意力必须在模型训练或架构中体现,不能简单作为标准 checkpoint 的通用运行时开关。
作者建议先明确瓶颈再选择技术:选模型时检查 KV 头数、局部/全局层比例、latent-attention 维度和循环层;服务既有模型时可先测试 FP8 并规范化前缀,再通过工作负载相关质量测试评估驱逐;若问题是延迟,可测量缓存读取和注意力时间;若非活跃会话占用 GPU,则测试外卸和调度。作者也强调组合带来的容量估算会掩盖模型质量、量化误差、上下文丢弃、内核支持和训练要求等限制。
- KV Cache
- LLM 推理服务
- 注意力优化
- GPU 内存管理
- 量化与缓存复用
英文原文 01
204 词 · 2 张图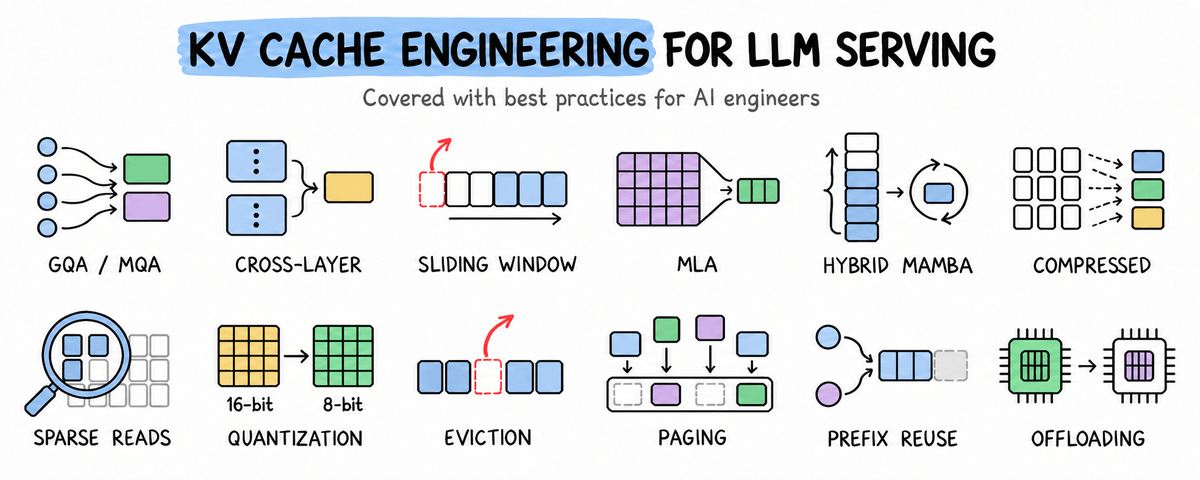
Everything you need to understand why the KV cache grows, the 12 ways models and serving engines reduce it, what each technique actually saves, and the trade-offs that decide which one fits your workload.
Loading an LLM is only the first part of GPU memory planning.
Model weights stay roughly fixed during inference. The KV cache does not. It grows with every token in the sequence, and by default, every active sequence needs its own cache.
For Llama 3.1 70B, one 128K-token sequence requires about 40 GB of BF16 KV cache. Four full-length sequences would add another 160 GB, before accounting for model weights and serving overhead.
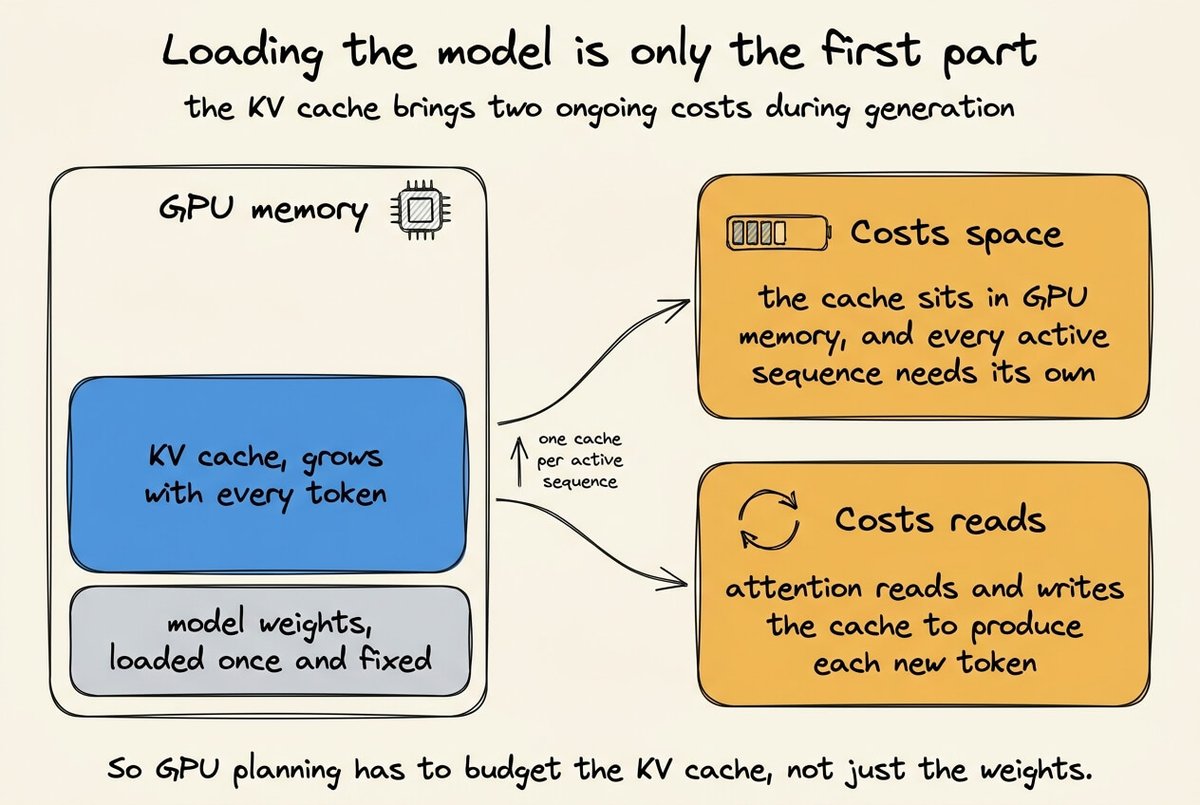
That creates two separate costs. The cache occupies GPU memory, and the attention layers must repeatedly read it while generating new tokens.
The techniques described as KV cache optimizations address different parts of this problem. Some change what the model stores. Some retain fewer tokens or use fewer bits. Others leave the logical cache intact and improve how the serving engine reads, allocates, shares, or moves it.
This article organizes twelve techniques by what they reduce, when they can be applied, and what trade-off remains. Each section includes a small runnable example that explains the main idea.
中文译文 01
375 字你需要了解的一切:KV 缓存为何会增长,模型和服务引擎如何通过 12 种方式减少它,每种技术实际节省什么,以及决定哪种技术适合你的工作负载的权衡。
加载 LLM 只是 GPU 内存规划的第一部分。
推理期间,模型权重大致保持不变。KV 缓存则不同。它会随着序列中的每个 token 增长,并且默认情况下,每个活跃序列都需要自己的缓存。
对于 Llama 3.1 70B,一个 128K token 的序列大约需要 40 GB 的 BF16 KV 缓存。四个完整长度的序列还会增加 160 GB,此计算尚未包括模型权重和服务开销。
这会产生两种不同的成本。缓存会占用 GPU 内存,而注意力层在生成新 token 时必须反复读取它。
被称为 KV 缓存优化的技术,解决的是这个问题的不同部分。有些技术改变模型存储的内容。有些技术保留更少的 token,或使用更少的比特。还有一些技术保留完整的逻辑缓存,但改进服务引擎读取、分配、共享或搬运缓存的方式。
本文按照每种技术减少的对象、可以应用的时机以及仍然存在的权衡,组织介绍十二种技术。每个部分都包含一个解释核心概念的小型可运行示例。
上下游
本块首次出现的来源与延伸
完整性仅针对提交文件,作者观点与事实核验分开。
本地原文已读取;线上来源未独立访问本块新增 1 项
判断
对本块内容的判断
这是作者对文章范围和目标的概括;具体节省量与权衡仍需结合后文及实际工作负载核验。 作者强调推理还涉及其他显存需求,但此处未具体列出。 “大致保持不变”和“默认情况下”保留了作者的限定;具体实现可能改变这些行为。 数字和“大约”均为原文表述;这里未提供计算过程,也未核验这些数值。 作者将成本区分为存储占用和反复读取;此处未量化二者的具体影响。 作者明确区分了逻辑缓存内容与服务引擎管理方式;具体技术效果需要分别判断。 原文声称每个部分都有可运行示例;当前输入中未提供这些示例。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
KV 缓存工程概览
本文将介绍 KV 缓存增长的原因、减少缓存的技术及其适用条件。
本文语境解释,未作为独立知识专题收录。
内存规划起点
模型加载并不等于完成推理阶段的显存规划。
本文语境解释,未作为独立知识专题收录。
缓存会随序列增长
权重通常是相对固定的显存占用,而 KV 缓存会按照生成或保留的 token 数量增长,并按活跃序列分别占用。
本文语境解释,未作为独立知识专题收录。
长序列的缓存成本
该例用 Llama 3.1 70B 和 128K token 序列说明 KV 缓存的规模,并展示并发序列会带来的额外显存需求。
本文语境解释,未作为独立知识专题收录。
缓存的两类成本
KV 缓存同时影响显存容量和生成期间注意力层的读取工作。
本文语境解释,未作为独立知识专题收录。
优化作用于不同环节
KV 缓存优化并非只有一种形式:它们可能改变缓存表示、缓存长度、精度,或改进缓存管理方式。
本文语境解释,未作为独立知识专题收录。
文章组织方式
文章将十二种技术按节省对象、应用时机和代价进行分类,并计划用示例说明。
本文语境解释,未作为独立知识专题收录。
本块新增 7 项
英文原文 02
251 词 · 2 张图The cache formula
Each attention layer stores one key and one value for every retained token.
The raw cache size for one sequence is:
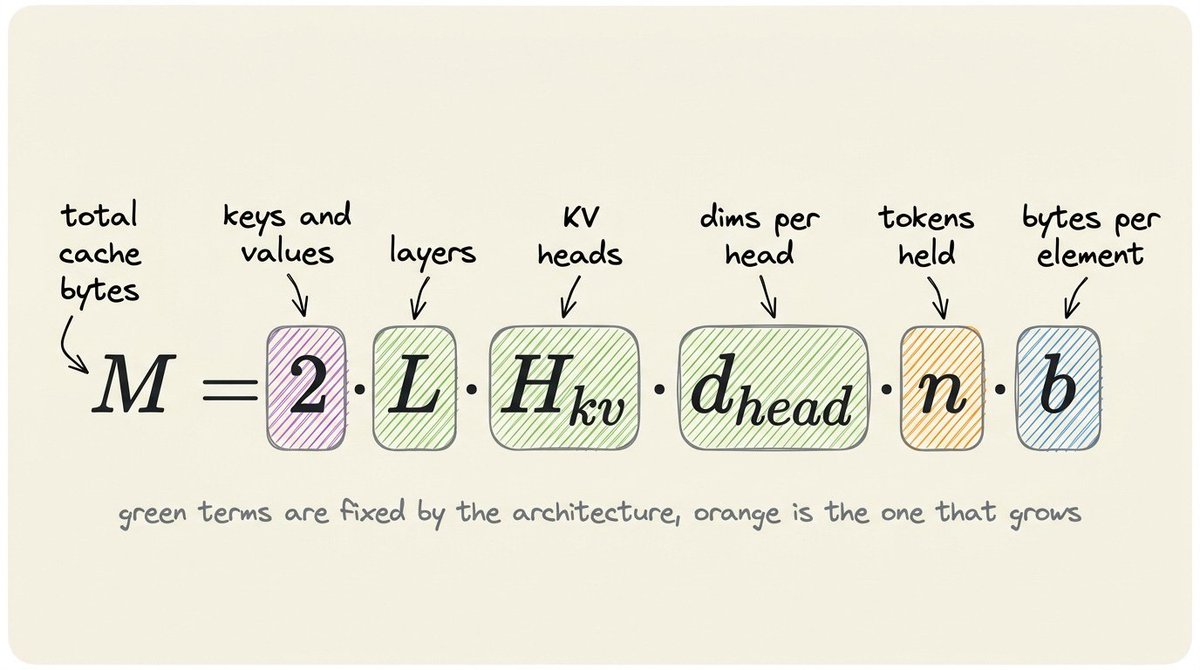
The leading 2 counts keys and values. BF16 uses two bytes per value, while FP8 uses one.
That formula also gives us a clean way to group the techniques:
- GQA and MQA reduce the number of KV heads.
- Cross-layer attention reduces the number of unique cached layers.
- Sliding windows and eviction reduce the number of retained tokens.
- MLA reduces the width of the stored representation.
- Quantization reduces the bytes used by each value.
- Hybrid recurrent layers replace a growing cache with fixed-size state.
- Paging and prefix reuse reduce allocation waste and duplicate blocks.
Sparse attention needs a separate line. It may read fewer tokens without removing them from memory, so it can cut attention work while leaving cache capacity unchanged.
This distinction matters when the GPU is full. A faster attention kernel doesn't create room for another sequence unless it also stores fewer bytes.
Technique map
The visual below puts all 12 techniques in one place, showing what each one changes and whether its main saving comes from fewer heads, layers, tokens, dimensions, bits, or duplicated memory.
The table above represents what each technique tries to tackle.
The quadrant below takes six representative techniques and reorganizes them by whether they reduce cache memory, attention work, or both. The full set remains in the table above.
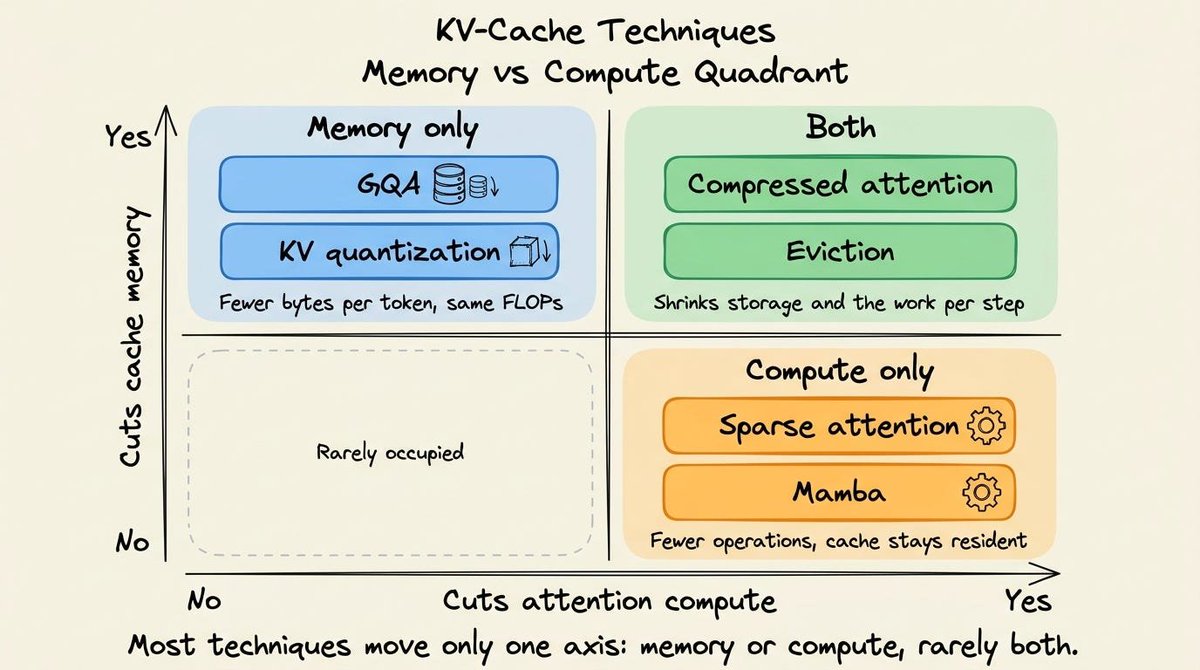
The rest of the article works through the full table in order.
中文译文 02
469 字缓存公式
每个注意力层都会为每个保留的 token 存储一个 key 和一个 value。
单个序列的原始缓存大小为:
开头的 2 表示 keys 和 values 的数量。BF16 每个值使用两个字节,而 FP8 使用一个字节。
这个公式还为我们提供了一种清晰的方式来对这些技术进行分组:
- GQA 和 MQA 减少 KV 头的数量。
- 跨层注意力减少唯一缓存层的数量。
- 滑动窗口和驱逐减少保留 token 的数量。
- MLA 减少所存储表示的宽度。
- 量化减少每个值所使用的字节数。
- 混合循环层用固定大小的状态替代不断增长的缓存。
- 分页和前缀复用减少分配浪费和重复块。
稀疏注意力需要单独说明。它可能在不将 token 从内存中移除的情况下读取更少的 token,因此可以减少注意力计算量,同时保持缓存容量不变。
当 GPU 已经满载时,这一区别很重要。更快的注意力内核不会为另一个序列腾出空间,除非它同时存储更少的字节。
技术图谱
下方的视觉图表将全部 12 种技术放在同一处,展示每种技术改变了什么,以及其主要节省来自更少的头、层、token、维度、比特,还是更少的重复内存。
上表代表了每种技术试图解决的问题。
下面的象限图选取了六种具有代表性的技术,并按照它们是减少缓存内存、减少注意力计算,还是两者兼顾,重新进行了整理。完整集合仍保留在上面的表格中。
文章的其余部分将按照完整表格中的顺序逐项展开。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是章节标题,不包含具体公式。 作者描述的是一般存储结构;此处未说明具体张量形状或实现细节。 原文在此处引出公式,但输入资料未包含公式本身。 数值和解释均按原文保留;这里未讨论其他数据类型或实际对齐开销。 这是后续列表的引导句;它没有声称这些类别涵盖所有可能的优化。 作者只说明减少对象,未在此处说明具体比例或质量代价。 这是作者对节省方向的概括;具体架构和效果尚待核验。 作者只指出缓存数量的变化;被移除 token 对模型效果的影响未在此处说明。 原文未展开 MLA 的具体机制、比例或代价。 作者只说明存储节省方向;精度损失和适用范围尚未在此处讨论。 作者描述了存储形式的变化;固定状态的具体大小和效果未给出。 作者指出了主要节省对象,但未提供实现条件或节省比例。 作者使用“可能”保留不确定性,并明确指出计算量下降不等于缓存容量下降。 这是作者关于显存容量边界的判断;具体效果取决于优化是否实际减少存储字节数。 这是章节标题,不包含额外事实。 原文提到下方视觉图表,但输入资料未包含图表内容,因此无法进一步核对其信息。 这是作者对表格作用的总结;具体表格内容在输入资料中未提供。 这是作者对图表组织方式的说明;具体分类是否准确取决于上方表格及各技术的定义。 这是作者对文章结构的说明,不涉及额外事实判断。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
缓存公式
本节将用公式说明 KV 缓存大小由哪些因素决定。
本文语境解释,未作为独立知识专题收录。
每个 token 的键值
KV 缓存的基本内容是注意力层针对保留 token 保存的 key 和 value。
本文语境解释,未作为独立知识专题收录。
原始缓存大小
这句话引出单个序列 KV 缓存大小的计算公式。
本文语境解释,未作为独立知识专题收录。
数据类型与字节数
公式中的 2 来自 key 和 value 两类数据;数据类型决定每个值占用的字节数。
本文语境解释,未作为独立知识专题收录。
按公式分组
缓存公式中的不同维度可以对应不同的优化方向。
本文语境解释,未作为独立知识专题收录。
减少 KV 头
这两种方法通过减少用于 KV 的头数量来降低相关缓存规模。
本文语境解释,未作为独立知识专题收录。
减少缓存层
跨层注意力通过让缓存层不再一一对应于所有层,减少需要存储的唯一层数量。
本文语境解释,未作为独立知识专题收录。
减少保留 token
这些方法限制或移除部分历史 token,使缓存不必保存全部序列内容。
本文语境解释,未作为独立知识专题收录。
缩窄存储表示
MLA 的节省方向是降低缓存中每个表示的宽度。
本文语境解释,未作为独立知识专题收录。
降低每值字节数
量化通过使用更低精度的表示,减少缓存中每个值的存储空间。
本文语境解释,未作为独立知识专题收录。
固定大小状态
这类架构不再让缓存随序列持续增长,而是使用固定大小的状态来承载信息。
本文语境解释,未作为独立知识专题收录。
减少分配与重复
这两种服务引擎技术分别针对内存分配效率和可共享前缀造成的重复存储。
本文语境解释,未作为独立知识专题收录。
稀疏注意力的区别
稀疏注意力减少的是每次读取或计算涉及的 token 数,而不一定减少缓存实际存储的 token 数。
本文语境解释,未作为独立知识专题收录。
速度不等于容量
优化读取或计算速度不能自动降低缓存的显存占用,因此不一定能增加可容纳的序列数量。
本文语境解释,未作为独立知识专题收录。
技术图谱
本节标题引出对十二种技术的整体对照。
本文语境解释,未作为独立知识专题收录。
十二种技术总览
该图表按缓存结构或管理中的不同维度,对十二种技术的主要节省来源进行并列展示。
本文语境解释,未作为独立知识专题收录。
表格所代表的内容
表格用于概括不同技术各自针对的缓存问题。
本文语境解释,未作为独立知识专题收录。
技术象限分类
本段说明象限图的分类依据,并指出完整技术列表仍可在前文表格中找到。
本文语境解释,未作为独立知识专题收录。
按表格顺序展开
本段交代后文结构:作者会依照完整表格的顺序解释各项内容。
本文语境解释,未作为独立知识专题收录。
本块新增 19 项
英文原文 03
216 词 · 3 张图1. GQA and MQA cache fewer heads
The cache formula above contains a term for KV heads. Reducing that term is one of the largest architectural savings available.
Inside each transformer layer, every token produces three representations:
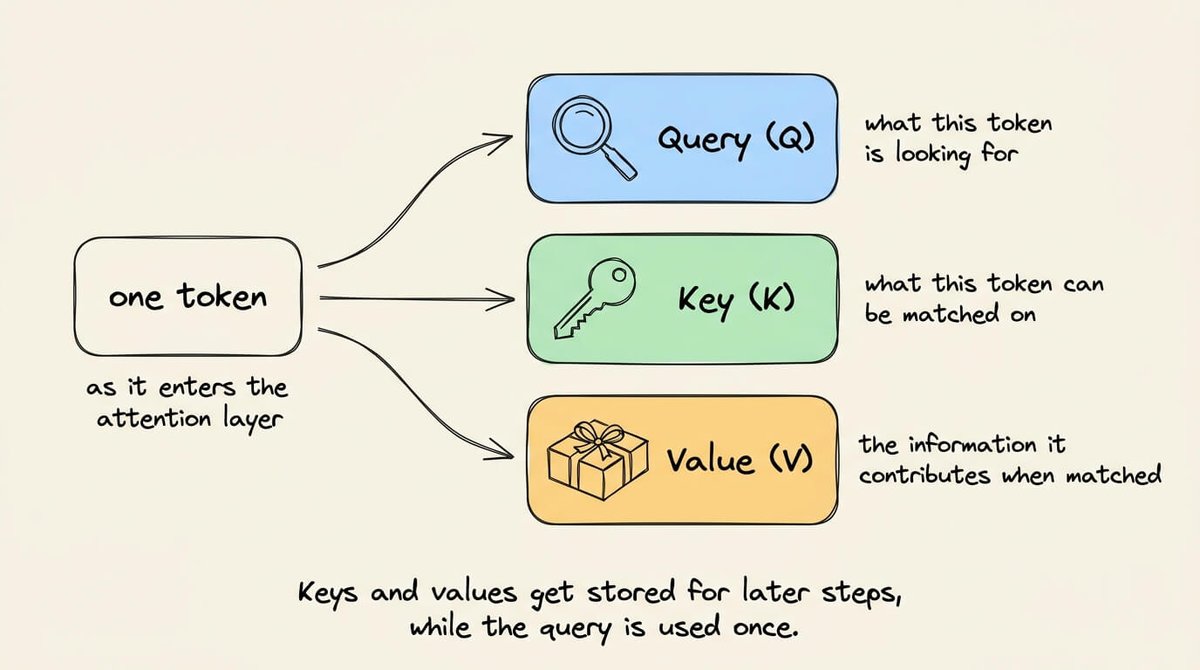
- The query represents what the current token needs.
- The key describes what each earlier token can match.
- The value carries the information returned when that match receives attention.
During generation, the current token's query is compared with cached keys.
Those comparisons produce attention weights, which combine the cached values. The layer keeps keys and values for later decoding steps. It does not keep the queries. I covered this below if you want to learn more:
 Avi Chawla@_avichawla·Aug 30Why KV cache stores K and V vectors but never Q?
(a popular technical LLM interview question)
LLMs are autoregressive so each token is predicted from every token before it, one at a time.
This autoregressive nature has a direct consequence inside the model.
A forward passGIFQuote
 Avi Chawla@_avichawla·Aug 28 ArticleKV, Prefix, Prompt and Semantic Caching in LLMs, clearly explainedEverything you need to understand where your input tokens are being recomputed and what to do about it. It covers the four cache layers from first principles, their trade-offs, what happens when they...932K
中文译文 03
383 字1. GQA 和 MQA 缓存更少的头
上面的缓存公式中包含一个 KV 头数量的项。减少这一项,是目前可获得的架构层面最大节省之一。
在每个 Transformer 层内,每个 token 都会产生三种表示:
- 查询表示当前 token 需要什么。
- 键描述每个更早 token 能够匹配什么。
- 值携带当该匹配获得注意力时所返回的信息。
在生成过程中,当前 token 的查询会与缓存的键进行比较。
这些比较会产生注意力权重,随后这些权重会组合缓存的值。该层会保留键和值,以供之后的解码步骤使用,但不会保留查询。如果你想进一步了解,我在下面介绍过这一点:
Avi Chawla@_avichawla·8月30日为什么 KV 缓存存储 K 和 V 向量,却从不存储 Q?
(一个很常见的技术类 LLM 面试问题)
LLM 具有自回归特性,因此每个 token 都会根据它之前的所有 token 逐个进行预测。
这种自回归特性会直接影响模型内部的计算。
一次前向传递GIF引用Avi Chawla@_avichawla·8月28日文章LLM 中的 KV、前缀、提示词和语义缓存,清晰解读理解输入 token 在哪里被重复计算,以及如何处理这些问题所需的一切内容。文章从第一性原理出发,介绍四个缓存层及其权衡、当它们……932K上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者对 GQA 和 MQA 作用的概括;具体节省幅度尚需结合模型结构与配置核验。 “最大节省之一”是作者的判断,适用程度取决于具体模型、序列长度和实现。 这是作者对后续 Q、K、V 作用说明的引入;未提供具体公式或模型配置。 这是对查询功能的简化解释,并非完整的数学定义。 这是作者的概念性说明;“能够匹配什么”未给出更具体的形式化定义。 这是对值向量作用的概念性说明,未展开具体计算过程。 这是作者对生成阶段注意力计算的描述;未说明具体实现或硬件行为。 这是作者对 KV 缓存机制的解释;其适用范围和具体细节可能因模型或实现而异。 仅依据原文保留署名,未对身份或内容进行外部核验。 仅依据原文保留账号信息,未核验账号归属。 这是原文排版符号。 原文未提供年份,因此仅保留月份和日期。 这是引用内容的开头片段,解释尚未在给定原文中完整呈现;不能据此补充后文。 给定资料未包含 GIF 的具体画面,因此无法进一步说明其内容。 仅保留原文标签,不对引用内容作额外核验。 仅依据原文保留署名,未进行外部核验。 这是界面标签,不代表对文章质量或真实性的判断。 标题所列主题来自原文;给定资料未提供文章正文,无法核验其覆盖范围。 这是原文的宣传性简介,且内容不完整;不能据此确认文章实际覆盖程度或结论。 仅保留原始数值;其含义尚无法从该单元确定。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
GQA 与 MQA 减少缓存头数
本节标题指出,分组查询注意力(GQA)和多查询注意力(MQA)通过减少需要缓存的头来节省缓存。
本文语境解释,未作为独立知识专题收录。
减少 KV 头数
作者将缓存开销公式中的 KV 头数量视为重要因素,因此认为从架构上减少该数量能够显著降低开销。
本文语境解释,未作为独立知识专题收录。
每个 token 的三种表示
本段引出 Transformer 注意力机制中的查询(Q)、键(K)和值(V)三种表示。
本文语境解释,未作为独立知识专题收录。
查询的作用
查询向量表达当前 token 在注意力计算中希望获取的信息。
本文语境解释,未作为独立知识专题收录。
键的作用
键向量用于表示此前 token 的可匹配特征,并与当前查询进行比较。
本文语境解释,未作为独立知识专题收录。
值的作用
值向量承载注意力加权后汇聚并返回给当前计算的信息。
本文语境解释,未作为独立知识专题收录。
查询与缓存键比较
作者说明自回归生成时,当前 token 产生的查询会用于和此前保存的键计算匹配关系。
本文语境解释,未作为独立知识专题收录。
缓存 K 和 V 而不缓存 Q
本段解释 KV 缓存的核心逻辑:查询用于当前步骤的匹配,键和值则被保留,以便后续解码重复使用。
本文语境解释,未作为独立知识专题收录。
作者姓名
这是所引用内容的作者署名。
本文语境解释,未作为独立知识专题收录。
作者账号
这是所引用内容显示的社交媒体账号。
本文语境解释,未作为独立知识专题收录。
分隔符
这是作者信息与日期之间的分隔符。
本文语境解释,未作为独立知识专题收录。
发布日期
这是所引用内容显示的日期。
本文语境解释,未作为独立知识专题收录。
为什么缓存 K 和 V 而不是 Q
这段引用提出 KV 缓存为何保存键和值而不保存查询的问题,并以自回归、逐 token 预测作为后续解释的背景。文本在“一次前向传递”处结束。
本文语境解释,未作为独立知识专题收录。
GIF 标记
这是原文中对 GIF 媒体或动图内容的标记。
本文语境解释,未作为独立知识专题收录。
引用标记
这是原文界面中表示引用内容的标签。
本文语境解释,未作为独立知识专题收录。
引用作者姓名
这是引用内容显示的作者署名。
本文语境解释,未作为独立知识专题收录。
引用作者账号
这是引用内容显示的社交媒体账号。
本文语境解释,未作为独立知识专题收录。
分隔符
这是作者信息与日期之间的分隔符。
本文语境解释,未作为独立知识专题收录。
引用日期
这是引用内容显示的日期。
本文语境解释,未作为独立知识专题收录。
内容类型
这是原文界面中对后续内容类型的标注。
本文语境解释,未作为独立知识专题收录。
LLM 中的四类缓存
这是相关文章标题,表明文章将讨论大语言模型中的 KV 缓存、前缀缓存、提示词缓存和语义缓存。
本文语境解释,未作为独立知识专题收录。
缓存层文章简介
这段简介声称文章将解释输入 token 的重复计算位置、应对方式、四个缓存层及其权衡;原文在“当它们……”处截断。
本文语境解释,未作为独立知识专题收录。
数值
这是原文中的数值片段,单独出现,未提供更多上下文。
本文语境解释,未作为独立知识专题收录。
本块新增 23 项
英文原文 04
208 词Attention splits these representations into smaller parts called heads.
A query head is one slice of the token's query representation. It is not the user's prompt or a separate model request. Different heads can learn to focus on different relationships in the same sequence.
- Standard multi-head attention, or MHA, gives each query head a matching key head and value head. A layer with eight query heads therefore produces eight key heads and eight value heads. Every attention layer performs this projection independently and keeps its own KV cache.
- Multi-query attention, or MQA, keeps all eight query heads but produces only one key head and one value head. Every query head reads from that shared KV pair. The sharing does not cross transformer layers.
- Grouped-query attention, or GQA, sits between these two layouts. It divides the query heads into groups and assigns one KV pair to each group. With eight query heads and two KV heads, four query heads share each KV pair.
All three methods operate inside each attention layer. They differ only in how many KV heads that layer stores. Cross-layer attention, covered next, is a separate idea that shares cached information between layers.
The GQA paper described it as an intermediate point between MHA and MQA.
中文译文 04
350 字注意力机制将这些表示拆分成称为“头”的更小部分。
查询头是该词元查询表示的一个切片。它不是用户的提示词,也不是单独的模型请求。不同的头可以学会关注同一序列中的不同关系。
- 标准多头注意力(MHA)为每个查询头配备一个匹配的键头和值头。因此,一个具有八个查询头的层会产生八个键头和八个值头。每个注意力层都会独立执行这一投影,并保留自己的 KV 缓存。
- 多查询注意力(MQA)保留全部八个查询头,但只产生一个键头和一个值头。每个查询头都从这一对共享的 KV 中读取。共享不会跨越 Transformer 层。
- 分组查询注意力(GQA)位于这两种布局之间。它将查询头划分为多个组,并为每个组分配一对 KV。对于八个查询头和两个 KV 头的情况,每四个查询头共享一对 KV。
这三种方法都在每个注意力层内部运行。它们的区别仅在于该层存储多少个 KV 头。下一节将介绍跨层注意力,这是在层之间共享缓存信息的另一种概念。
GQA 论文将其描述为 MHA 与 MQA 之间的中间点。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者对注意力表示划分方式的陈述;未涉及具体模型配置。 这是对查询头概念和功能的说明;“可以学会”描述的是模型可能形成的关注模式,并非对每个模型的核验结果。 这是作者对 MHA 布局和层内缓存方式的概括;具体实现可能还受模型架构细节影响。 这是作者对 MQA 共享范围的描述;不应将其理解为不同 Transformer 层之间也共享缓存。 文中的四比一共享关系只针对八个查询头、两个 KV 头这一示例配置。 这是文章的概念边界说明;跨层注意力不属于前述三种层内布局本身。 这是作者对 GQA 论文表述的转述;未在此处提供论文引用细节。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
注意力头
本句说明注意力表示的结构:整体表示会被划分为多个较小的头。
本文语境解释,未作为独立知识专题收录。
查询头的含义
作者区分了查询头与用户输入或模型请求,强调查询头只是词元查询表示的一部分,并可分别建模序列中的关系。
本文语境解释,未作为独立知识专题收录。
标准多头注意力
MHA 为每个查询头分别配置键和值头,因此查询头、键头和值头的数量相同;缓存按注意力层分别保存。
本文语境解释,未作为独立知识专题收录。
多查询注意力
MQA 让多个查询头共同读取一对键和值头,从而减少每层保存的 KV 头数量;这种共享范围限制在单层内。
本文语境解释,未作为独立知识专题收录。
分组查询注意力
GQA 在 MHA 的逐头配置与 MQA 的全头共享之间折中,以查询头分组的方式分配 KV 头。
本文语境解释,未作为独立知识专题收录。
层内与跨层共享
作者将 MHA、MQA 和 GQA 的层内头共享,与跨层注意力的层间缓存共享区分开来。
本文语境解释,未作为独立知识专题收录。
GQA 的位置
本句用连续布局中的位置概括 GQA:它在每头独立的 MHA 与高度共享的 MQA 之间。
本文语境解释,未作为独立知识专题收录。
本块新增 7 项
英文原文 05
263 词The authors converted existing MHA checkpoints and used 5 percent of the original pretraining compute for recovery training. Their uptrained GQA models stayed close to MHA quality while approaching MQA speed.
The following example uses eight query heads. It shows which KV head each query head reads. It also counts the cached scalars for six tokens:
query_heads = 8
tokens = 6
head_size = 8

for name, kv_heads in [("MHA", 8), ("GQA", 2), ("MQA", 1)]:
    queries_per_kv_head = query_heads // kv_heads
    mapping = [head // queries_per_kv_head for head in range(query_heads)]
    cached_scalars = 2 * kv_heads * tokens * head_size

    print(name, "mapping:", mapping)
    print(name, "cached scalars:", cached_scalars)

# Output:
"""
MHA mapping: [0, 1, 2, 3, 4, 5, 6, 7]
MHA cached scalars: 768
GQA mapping: [0, 0, 0, 0, 1, 1, 1, 1]
GQA cached scalars: 192
MQA mapping: [0, 0, 0, 0, 0, 0, 0, 0]
MQA cached scalars: 96
"""
The mapping lists one KV head number for every query head. MHA uses a different KV head each time. GQA shares KV head 0 across four queries, then does the same with KV head 1. MQA maps every query head to KV head 0.
The cache count includes both keys and values. It then multiplies by six tokens and eight scalars per head.
Llama 3.1 70B uses 64 query heads and 8 KV heads. At 128K context, that produces a 40 GB BF16 cache instead of the 320 GB required by the same shape with 64 KV heads.
This code proves the storage ratio. It doesn't test quality, because head sharing changes what the model learns and must be evaluated after training.
中文译文 05
384 字作者将现有的 MHA 检查点转换过来,并使用原始预训练计算量的 5% 进行恢复训练。他们经过额外训练的 GQA 模型在质量上保持接近 MHA,同时速度接近 MQA。
下面的示例使用八个查询头。它展示每个查询头读取哪个 KV 头,也统计六个词元所对应的缓存标量数量:
query_heads = 8
tokens = 6
head_size = 8

for name, kv_heads in [("MHA", 8), ("GQA", 2), ("MQA", 1)]:
    queries_per_kv_head = query_heads // kv_heads
    mapping = [head // queries_per_kv_head for head in range(query_heads)]
    cached_scalars = 2 * kv_heads * tokens * head_size

    print(name, "mapping:", mapping)
    print(name, "cached scalars:", cached_scalars)

# Output:
"""
MHA mapping: [0, 1, 2, 3, 4, 5, 6, 7]
MHA cached scalars: 768
GQA mapping: [0, 0, 0, 0, 1, 1, 1, 1]
GQA cached scalars: 192
MQA mapping: [0, 0, 0, 0, 0, 0, 0, 0]
MQA cached scalars: 96
"""映射为每个查询头列出一个 KV 头编号。MHA 每次都使用不同的 KV 头。GQA 让四个查询头共享 KV 头 0,然后让另外四个查询头共享 KV 头 1。MQA 则将每个查询头都映射到 KV 头 0。
缓存计数同时包括键和值。然后再乘以六个词元,以及每个头的八个标量。
Llama 3.1 70B 使用 64 个查询头和 8 个 KV 头。在 128K 上下文下,这会产生一个 40 GB 的 BF16 缓存;如果采用相同形状但使用 64 个 KV 头,则需要 320 GB。
这段代码证明了存储比例。它不会测试质量,因为头共享会改变模型学到的内容,必须在训练后进行评估。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
“质量接近 MHA、速度接近 MQA”是作者对其实验结果的归纳;原文未给出具体评测指标或数据。 示例中的数量仅适用于随后代码给出的参数。 仅说明代码语言,不代表代码已被运行或核验。 代码及其注释输出是原文提供的示例;此处不声称已执行代码,也不据此验证模型质量。 四个查询头共享一个 KV 头的说法对应示例中的八个查询头和两个 KV 头。 这是该示例的计数逻辑;其中六个词元和每头八个标量是示例参数。 文中的模型配置、上下文长度和 GB 数值均为作者给出的陈述;本单元未提供独立核验依据。 代码只能支持存储比例这一范围内的结论,不能据此推出质量表现。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
GQA 的恢复训练
该段描述一种从已有 MHA 检查点转换到 GQA 的训练做法,并比较了训练后模型的质量与速度表现。
本文语境解释,未作为独立知识专题收录。
头映射示例
示例将比较八个查询头在 MHA、GQA 和 MQA 中的 KV 映射,并计算六个词元需要缓存的标量数。
本文语境解释,未作为独立知识专题收录。
代码语言标记
这是代码单元前的语言标记,表明后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
KV 头映射与缓存计数代码
代码设置八个查询头、六个词元和每头八个标量,分别计算 MHA、GQA、MQA 中每个查询头对应的 KV 头,以及同时存储键和值时的缓存标量数量。映射通过每个 KV 头承接的查询头数量计算;缓存数量通过键和值数量、KV 头数、词元数和每头大小相乘得到。注释中的输出展示了三种布局的映射和计数。
本文语境解释,未作为独立知识专题收录。
查询头到 KV 头的映射
本句解释上一段代码中的映射列表,比较三种注意力布局如何分配或共享 KV 头。
本文语境解释,未作为独立知识专题收录。
缓存计数公式
缓存大小先将键和值都计入,再结合词元数量和每个头的标量数量计算总数。
本文语境解释,未作为独立知识专题收录。
Llama 3.1 70B 的缓存规模
该段用具体模型配置和上下文长度说明减少 KV 头数量如何降低 BF16 KV 缓存的存储需求。
本文语境解释,未作为独立知识专题收录。
存储比例与质量评估
作者区分了代码能够说明的存储量变化与不能说明的模型质量变化;头共享带来的质量影响需要训练后评测。
本文语境解释,未作为独立知识专题收录。
本块新增 8 项
英文原文 06
256 词2. Cross-layer attention
GQA shares keys and values across heads within one layer. Cross-layer attention shares them across adjacent layers.
So a sharing factor of two implies two attention layers use one set of cached keys and values. The model now stores half as many unique layer caches.
The Cross-Layer Attention (CLA) paper trained 1B and 3B models and reported another 2x KV cache reduction while keeping accuracy close to the MQA baseline.
The next script represents two layers sharing one cache allocation:
tokens = 32
kv_heads = 2
head_size = 8

one_layer_cache = 2 * tokens * kv_heads * head_size
shared_cache = {"stored_scalars": one_layer_cache}
layer_caches = [shared_cache, shared_cache]

separate_total = 2 * one_layer_cache
shared_total = shared_cache["stored_scalars"]

print("layers point to same cache:", layer_caches[0] is layer_caches[1])
print("two separate layer caches:", separate_total, "scalars")
print("one shared layer cache:", shared_total, "scalars")

# Output:
"""
layers point to same cache: True
two separate layer caches: 2048 scalars
one shared layer cache: 1024 scalars
"""
One layer would store 1,024 scalars here. The leading 2 counts keys and values. Two independent layers would therefore store 2,048 scalars.
Both items in layer_caches point to the same Python object. The physical storage remains 1,024 scalars even though two logical layers use it.
Cross-layer sharing compounds GQA because it reduces a different term. GQA stores fewer KV heads inside each layer. CLA stores fewer distinct layer caches across the model.
A standard checkpoint learns separate KV projections for every layer. Each layer expects the cache created by its own weights. Redirecting it to another layer's cache changes the model's computation.
中文译文 06
408 字2. 跨层注意力
GQA 在一个层内的不同头之间共享键和值。跨层注意力则在相邻层之间共享它们。
因此,大小为 2 的共享因子意味着两个注意力层使用同一组缓存的键和值。模型现在存储的独特层缓存数量减少了一半。
跨层注意力(CLA)论文训练了 1B 和 3B 模型,并报告称,在保持准确率接近 MQA 基线的同时,又将 KV 缓存减少了 2 倍。
下一个脚本表示两个层共享一次缓存分配:
tokens = 32
kv_heads = 2
head_size = 8

one_layer_cache = 2 * tokens * kv_heads * head_size
shared_cache = {"stored_scalars": one_layer_cache}
layer_caches = [shared_cache, shared_cache]

separate_total = 2 * one_layer_cache
shared_total = shared_cache["stored_scalars"]

print("layers point to same cache:", layer_caches[0] is layer_caches[1])
print("two separate layer caches:", separate_total, "scalars")
print("one shared layer cache:", shared_total, "scalars")

# Output:
"""
layers point to same cache: True
two separate layer caches: 2048 scalars
one shared layer cache: 1024 scalars
"""在这里,一个层会存储 1,024 个标量。开头的 2 计算了键和值。因此,两个相互独立的层会存储 2,048 个标量。
layer_caches 中的两个条目都指向同一个 Python 对象。尽管有两个逻辑层在使用它,物理存储仍然只有 1,024 个标量。
跨层共享与 GQA 叠加,因为它减少的是不同的项。GQA 减少每一层内部存储的 KV 头数量。CLA 减少整个模型中不同层缓存的数量。
标准检查点会为每一层学习独立的 KV 投影。每一层都期待使用由自身权重创建的缓存。将它重定向到另一层的缓存会改变模型的计算。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题本身未给出更多实现或效果信息。 这是作者对两种机制共享范围的定义;“相邻层”是原文限定。 减半结论以共享因子为 2 且共享确实可实现为前提;未讨论其他内存开销。 “减少了 2 倍”和“准确率接近”是原文的报告性表述;本单元未提供具体实验设置或独立核验结果。 这是简化的表示示例,不等同于完整的跨层注意力实现。 仅说明代码语言,不代表代码已被运行或核验。 代码展示的是共享对象和存储计数的简化模型;此处不声称已执行代码,也不据此验证实际模型效果。 这些数值仅适用于前文给出的 32 个词元、2 个 KV 头和每头 8 个标量的示例。 这是对对象引用与物理存储关系的说明;文中未进一步说明具体实现或运行时开销。 这是作者对两种机制作用维度的概括;未给出组合后的具体节省比例。 这是作者对标准检查点行为的描述;未讨论在特定架构中是否存在例外。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
跨层注意力
这是介绍跨层注意力机制的章节标题。
本文语境解释,未作为独立知识专题收录。
跨层共享与 GQA
本句对比两种共享维度:GQA 的共享发生在单层内的头之间,而跨层注意力的共享发生在相邻层之间。
本文语境解释,未作为独立知识专题收录。
共享因子为二
当两个层共同使用一份 KV 缓存时,相对于各自独立保存缓存,独特的层缓存数量减半。
本文语境解释,未作为独立知识专题收录。
CLA 的缓存减少
该段转述 CLA 论文的实验报告:在 1B 和 3B 模型上,跨层共享进一步减少 KV 缓存,并以 MQA 作为准确率比较基线。
本文语境解释,未作为独立知识专题收录。
共享缓存分配示例
后续代码用两个层指向同一个缓存对象的方式,表示跨层共享一份缓存分配。
本文语境解释,未作为独立知识专题收录。
代码语言标记
这是代码单元前的语言标记,表明后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
跨层共享缓存代码
代码设置 32 个词元、2 个 KV 头和每头 8 个标量,先计算一个层独立缓存所需的标量数,再让两个层引用同一个缓存对象,并比较独立缓存与共享缓存的总量。注释中的输出显示,两个独立层缓存需要 2048 个标量,共享一份缓存需要 1024 个标量。
本文语境解释,未作为独立知识专题收录。
独立与共享缓存计数
本句解释示例中的数值:单层缓存包含键和值共 1024 个标量,两个独立层则将这一数量相加。
本文语境解释,未作为独立知识专题收录。
共享同一对象
本段说明跨层缓存共享如何减少物理存储:多个逻辑层可以引用同一个缓存对象。
本文语境解释,未作为独立知识专题收录。
CLA 与 GQA 的互补节省
本段区分两种节省来源:GQA 针对每层的 KV 头数,CLA 针对模型范围内的层缓存数。
本文语境解释,未作为独立知识专题收录。
标准检查点的独立缓存
本段解释标准模型中层与自身 KV 投影、缓存之间的对应关系,以及跨层重定向可能改变计算。
本文语境解释,未作为独立知识专题收录。
本块新增 11 项
英文原文 07
223 词A CLA model trains with the sharing pattern already present. Training lets each dependent layer adapt to the shared cache. The serving engine must then reproduce the same ownership pattern.
The checkpoint and engine must agree on which layer owns each cache. This is why CLA cannot be enabled as a generic runtime flag.
3. Sliding windows
CLA reduces the number of stored layer caches. Sliding-window attention reduces the tokens stored inside selected layers.
In full self-attention, each new token can attend to every earlier token. Each attention layer must therefore keep keys and values for the full sequence. As the sequence grows, every layer's KV cache grows with it.
Sliding-window attention limits a layer to recent tokens. Suppose the window contains 1,024 positions. That layer stores KV entries for only the latest 1,024 tokens. Each new entry removes the oldest one after the window fills. Its cache then stays fixed at 1,024 positions.
We call this a local layer because it sees nearby context. A global layer can still attend to every earlier token. Its cache keeps growing until the sequence ends.
Many models mix both layer types. Local layers provide most of the memory saving. Occasional global layers preserve access to distant parts of the prompt. The total cache still grows, but much slower than full attention everywhere.
中文译文 07
407 字CLA 模型在共享模式已经存在的情况下进行训练。训练使每个依赖层都能适应共享缓存。随后,服务引擎必须复现同样的所有权模式。
检查点和引擎必须就每个缓存由哪一层拥有达成一致。这就是 CLA 不能作为通用运行时开关启用的原因。
3. 滑动窗口
CLA 减少存储的层缓存数量。滑动窗口注意力减少选定层内部存储的令牌数量。
在完整自注意力中,每个新令牌都可以关注之前的每个令牌。因此,每个注意力层都必须保存完整序列的键和值。随着序列增长,每一层的 KV 缓存也随之增长。
滑动窗口注意力将一层限制在最近的令牌范围内。假设窗口包含 1,024 个位置。该层只为最近的 1,024 个令牌存储 KV 条目。窗口填满后,每个新条目都会移除最旧的条目。这样,其缓存就会固定在 1,024 个位置。
我们将这种层称为局部层,因为它只能看到附近的上下文。全局层仍然可以关注之前的每个令牌。它的缓存会持续增长,直到序列结束。
许多模型会混合使用这两种层。局部层提供大部分内存节省。偶尔出现的全局层保留对提示中较远部分的访问能力。缓存总量仍会增长,但比处处使用完整注意力时慢得多。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
作者主张训练配置与服务实现必须一致;未提供具体的检查点格式或引擎实现细节。 这是作者给出的因果解释;具体引擎是否支持其他形式的动态配置,本文未作说明。 这是章节标题,不包含更多技术主张。 这是概念层面的对比;未量化两种方法各自的节省幅度。 这是对完整自注意力缓存需求的概括;未涉及具体实现中的压缩或分页策略。 示例假设窗口为 1,024 个位置;实际模型的窗口大小可能不同。 这是文中采用的术语和行为描述;未说明全局层在所有架构中都必然存在。 作者使用“许多模型”和“大部分”等概括性表述;未给出普遍适用的层比例或节省量。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
训练与服务必须匹配
本段说明 CLA 的共享关系是训练阶段模型行为的一部分,因此部署时需要保持相同的缓存归属关系。
本文语境解释,未作为独立知识专题收录。
CLA 不是通用开关
本段将 CLA 的限制归因于检查点中的层间缓存所有权模式,运行时不能脱离该模式单独启用。
本文语境解释,未作为独立知识专题收录。
滑动窗口
本节转向另一种 KV 缓存优化:限制选定层所保留的令牌范围。
本文语境解释,未作为独立知识专题收录。
两种不同的缓存缩减
本段对比 CLA 与滑动窗口注意力:前者减少缓存层的数量,后者减少某些层中缓存令牌的数量。
本文语境解释,未作为独立知识专题收录。
完整注意力的缓存增长
由于完整自注意力保留对所有历史令牌的访问,每层都需要保存整个序列对应的键和值。
本文语境解释,未作为独立知识专题收录。
固定大小的局部窗口
本段说明窗口达到上限后如何用新令牌替换最旧令牌,使该层的缓存容量保持不变。
本文语境解释,未作为独立知识专题收录。
局部层与全局层
本段定义局部层和全局层的区别:局部层受窗口限制,全局层保留完整历史访问能力。
本文语境解释,未作为独立知识专题收录。
混合局部与全局层
混合设计让多数层使用固定窗口,同时用少量全局层维持远距离上下文访问,从而降低总体缓存增长速度。
本文语境解释,未作为独立知识专题收录。
本块新增 8 项
英文原文 08
268 词For instance, Gemma 3 uses a repeating pattern of five local layers followed by one global layer. Its local window is 1,024 tokens, while the global layer supports the full 128K context:
The following example tracks the positions retained by a four-token window:
window_size = 4
retained_positions = []

for position in range(10):
    retained_positions.append(position)

    if len(retained_positions) > window_size:
        retained_positions.pop(0)

    print(f"after token {position}: {retained_positions}")

print("maximum retained positions:", window_size)

# Output:
"""
after token 0: [0]
after token 1: [0, 1]
after token 2: [0, 1, 2]
after token 3: [0, 1, 2, 3]
after token 4: [1, 2, 3, 4]
after token 5: [2, 3, 4, 5]
after token 6: [3, 4, 5, 6]
after token 7: [4, 5, 6, 7]
after token 8: [5, 6, 7, 8]
after token 9: [6, 7, 8, 9]
maximum retained positions: 4
"""
The list fills with positions 0 through 3. When position 4 arrives, the list becomes too long. Removing its first item drops position 0.
The same step repeats for every later token. Production engines usually use a ring buffer, which overwrites old slots without moving the remaining entries.
The first four tokens fill the available slots. Token 4 then removes token 0, so the window shifts to positions 1 through 4. Every later token shifts that range forward by one. After token 9, only positions 6 through 9 remain. The allocation stays fixed at four slots throughout.
The ratio also changes with context length. Below 1,024 tokens, both layouts retain the same number of positions. The saving appears only after the sequence exceeds the local window.
中文译文 08
393 字例如,Gemma 3 使用五个局部层后接一个全局层的重复模式。其局部窗口为 1,024 个令牌,而全局层支持完整的 128K 上下文:
下面的示例跟踪一个保留四个令牌位置的窗口:
window_size = 4
retained_positions = []

for position in range(10):
    retained_positions.append(position)

    if len(retained_positions) > window_size:
        retained_positions.pop(0)

    print(f"after token {position}: {retained_positions}")

print("maximum retained positions:", window_size)

# Output:
"""
after token 0: [0]
after token 1: [0, 1]
after token 2: [0, 1, 2]
after token 3: [0, 1, 2, 3]
after token 4: [1, 2, 3, 4]
after token 5: [2, 3, 4, 5]
after token 6: [3, 4, 5, 6]
after token 7: [4, 5, 6, 7]
after token 8: [5, 6, 7, 8]
after token 9: [6, 7, 8, 9]
maximum retained positions: 4
"""列表先填入位置 0 到 3。当位置 4 到来时,列表长度超出限制。移除它的第一个元素后,位置 0 被丢弃。
对于之后的每个令牌,都会重复相同步骤。生产环境的引擎通常使用环形缓冲区,在不移动其余条目的情况下覆盖旧槽位。
前四个令牌填满可用槽位。随后,令牌 4 移除令牌 0,因此窗口移动到位置 1 到 4。之后每个令牌都会使这个范围向前移动一位。在令牌 9 之后,只剩下位置 6 到 9。整个过程中,分配的空间始终固定为四个槽位。
该比例还会随上下文长度变化。在少于 1,024 个令牌时,两种布局保留的位置数量相同。只有当序列超过局部窗口后,节省才会出现。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
数字和归属均为原文所述;本文未在此处提供对该模型配置的独立核验。 这是示例设定,窗口大小为四;不代表前文的 1,024 令牌配置。 仅依据原文的语言标记;未执行或核验代码。 代码及其输出均为原文内容;本说明不声称已运行代码。 这是与前述四位置示例一致的过程描述;未涉及环形缓冲区的具体实现。 “通常使用”是作者的概括;本文未列出具体引擎或基准结果。 结论适用于文中四位置窗口示例;不等同于所有滑动窗口实现的完整内存行为。 原文以 1,024 为局部窗口示例;具体比例未给出。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
Gemma 3 的层模式
本段给出一个具体模式示例,用五个局部层配一个全局层,并列出局部窗口与全局上下文长度。
本文语境解释,未作为独立知识专题收录。
四令牌窗口示例
本段引出一个小型示例,用于展示滑动窗口如何随新令牌到来而保留位置。
本文语境解释,未作为独立知识专题收录。
Python 示例标记
这是代码块的语言标记,表明后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
滑动窗口代码
代码将窗口大小设为 4,依次处理位置 0 到 9:每次加入当前位置;如果列表超过窗口大小,就移除第一个位置;随后打印当前保留位置,并打印最大保留位置。注释中的输出展示了窗口从 [0, 1, 2, 3] 逐步滑到 [6, 7, 8, 9]。
本文语境解释,未作为独立知识专题收录。
窗口移除最旧位置
本段用位置 4 的到来说明窗口满后如何删除最早保留的位置。
本文语境解释,未作为独立知识专题收录。
环形缓冲区实现
本段说明生产引擎可以用环形缓冲区复用固定槽位,避免每次窗口滑动都移动剩余条目。
本文语境解释,未作为独立知识专题收录。
窗口逐步前移
本段总结四槽位窗口从位置 0 到 3 逐步前移到位置 6 到 9 的过程,并强调容量不变。
本文语境解释,未作为独立知识专题收录。
节省取决于上下文长度
本段指出,在序列尚未超过局部窗口时,局部布局与完整布局需要保留相同数量的位置;超出窗口后才产生节省。
本文语境解释,未作为独立知识专题收录。
本块新增 8 项
英文原文 09
307 词4. Multi-head latent attention
Multi-head latent attention, or MLA, doesn't cache a complete key and value for every head. It compresses the hidden state into a smaller latent representation and stores that instead.
During decode, the model uses learned projections to recover the information needed by attention.
Implementations can absorb parts of those projections into the query and output paths, which avoids reconstructing every full KV tensor in memory.
DeepSeek-V2 introduced this design. The paper reported a 93.3 percent KV cache reduction compared with DeepSeek 67B and a 5.76x increase in maximum generation throughput:
An actual MLA layer uses learned matrices to create and use the latent representation. Those matrix operations hide the basic memory difference in a small example.
The following example counts storage for one token. The dimensions are intentionally small. They make the difference between both layouts visible.
kv_heads = 4
head_size = 8

standard_keys = kv_heads * head_size
standard_values = kv_heads * head_size
standard_total = standard_keys + standard_values

mla_latent = 8
mla_rotary_key = 4
mla_total = mla_latent + mla_rotary_key

print("standard cache:", standard_keys, "key +", standard_values, "value")
print("MLA cache:", mla_latent, "latent +", mla_rotary_key, "rotary key")
print("stored scalars per token:", standard_total, "->", mla_total)
print(f"example reduction: {standard_total / mla_total:.2f}x")

# Output:
"""
standard cache: 32 key + 32 value
MLA cache: 8 latent + 4 rotary key
stored scalars per token: 64 -> 12
example reduction: 5.33x
"""
Four KV heads with eight scalars each produce 32 key scalars. The values require another 32. Standard attention therefore stores 64 scalars per token.
The illustrative MLA layout stores eight latent scalars and four positional scalars. Its total is 12. Dividing 64 by 12 gives the example ratio.
The 5.33x figure belongs only to this example. Real MLA models choose different latent and positional dimensions.
MLA is not an inference flag for a standard checkpoint. Its projection weights and cache layout belong to the trained model. Converting another model still requires training.
中文译文 09
484 字4. 多头潜在注意力
多头潜在注意力(MLA)不会为每个头缓存完整的键和值。它会将隐藏状态压缩成较小的潜在表示,并改为存储该表示。
在解码期间,模型使用学习到的投影来恢复注意力所需的信息。
实现可以将这些投影的一部分吸收到查询路径和输出路径中,从而避免在内存中重建每个完整的 KV 张量。
DeepSeek-V2 引入了这种设计。论文报告称,与 DeepSeek 67B 相比,KV 缓存减少了 93.3%,最大生成吞吐量提高了 5.76 倍:
实际的 MLA 层使用经过学习的矩阵来创建和使用潜在表示。这些矩阵运算会掩盖一个小例子中基本的内存差异。
下面的示例计算一个 token 的存储量。维度被刻意设置得很小,以便显现两种布局之间的差异。
kv_heads = 4
head_size = 8

standard_keys = kv_heads * head_size
standard_values = kv_heads * head_size
standard_total = standard_keys + standard_values

mla_latent = 8
mla_rotary_key = 4
mla_total = mla_latent + mla_rotary_key

print("standard cache:", standard_keys, "key +", standard_values, "value")
print("MLA cache:", mla_latent, "latent +", mla_rotary_key, "rotary key")
print("stored scalars per token:", standard_total, "->", mla_total)
print(f"example reduction: {standard_total / mla_total:.2f}x")

# Output:
"""
standard cache: 32 key + 32 value
MLA cache: 8 latent + 4 rotary key
stored scalars per token: 64 -> 12
example reduction: 5.33x
"""四个 KV 头、每个头包含八个标量,会产生 32 个 key 标量。value 还需要另外 32 个。因此,标准注意力每个 token 会存储 64 个标量。
示例中的 MLA 布局存储八个潜在标量和四个位置标量,总数为 12。用 64 除以 12,便得到示例中的比例。
5.33 倍这个数字只属于本示例。实际 MLA 模型会选择不同的潜在维度和位置维度。
MLA 不是标准 checkpoint 的一个推理标志。它的投影权重和缓存布局属于经过训练的模型。要转换另一个模型,仍然需要训练。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是章节标题;后续段落提供 MLA 的具体机制和数据。 这是作者对 MLA 缓存形式的概括;未说明压缩表示的具体维度或损失。 原文未详细说明恢复过程是显式重建还是通过其他等价计算完成。 作者说明的是“可以”采用的实现策略;未给出具体实现或性能数据。 93.3% 和 5.76 倍是原文归因于论文的报告值;本文未提供独立核验,也未说明测量条件。 这是对实际 MLA 结构的概括;原文没有在此处给出具体矩阵或实现细节。 该示例仅用于展示差异,不能直接代表实际模型的维度。 这里只说明代码语言,没有提供其他技术结论。 代码中的输出是原文提供的示例结果;5.33 倍只适用于这些设定,不能据此推断所有 MLA 模型。 结论仅适用于文中给定的头数和头维度。 这里的 12 和由此得到的比例属于示例设定,不是普遍的 MLA 固定值。 不能把该比例外推到所有实际 MLA 模型。 原文断言转换另一个模型仍需训练;没有进一步说明所需训练方式或成本。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
多头潜在注意力
本节介绍 MLA,一种通过存储较小潜在表示来降低 KV 缓存需求的方法。
本文语境解释,未作为独立知识专题收录。
MLA 压缩隐藏状态
本段说明 MLA 不直接保存每个注意力头的完整 KV,而是保存压缩后的潜在表示。
本文语境解释,未作为独立知识专题收录。
解码时恢复信息
本段说明模型在生成解码阶段通过训练得到的投影,从潜在表示中取得注意力所需的信息。
本文语境解释,未作为独立知识专题收录。
吸收投影以避免重建
本段描述一种实现方式:把部分投影并入查询和输出路径,减少对完整 KV 张量显式重建的需要。
本文语境解释,未作为独立知识专题收录。
DeepSeek-V2 的 MLA 数据
本段将 MLA 设计归于 DeepSeek-V2,并引用论文报告的 KV 缓存减少比例和最大生成吞吐量提升倍数。
本文语境解释,未作为独立知识专题收录。
实际 MLA 层
作者指出,真实 MLA 通过学习到的矩阵处理潜在表示,因此其底层缓存差异不一定能从简单示例中直接看出。
本文语境解释,未作为独立知识专题收录。
单个 token 的存储示例
示例通过缩小维度,直接比较标准 KV 缓存布局和 MLA 布局的存储元素数量。
本文语境解释,未作为独立知识专题收录。
代码语言
该单元标识后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
KV 缓存存储计算
代码设置标准注意力和 MLA 的示例维度,分别计算每个 token 需要存储的标量数量,并输出二者的示例缩减比例。原文给出的输出显示,标准缓存为 64 个标量,MLA 缓存为 12 个标量,比例为 5.33 倍。
本文语境解释,未作为独立知识专题收录。
标准注意力的存储量
作者将 key 和 value 分开计数:四个头乘以每头八个标量得到 32 个 key 标量,value 数量相同,合计 64 个。
本文语境解释,未作为独立知识专题收录。
MLA 布局的存储量
该段把 MLA 的两类存储量相加,再与标准注意力的 64 个标量相比,得到示例比例。
本文语境解释,未作为独立知识专题收录。
示例比例的适用范围
作者明确限制了 5.33 倍这一结果的适用范围,并指出实际模型的相关维度可能不同。
本文语境解释,未作为独立知识专题收录。
MLA 需要模型训练
作者强调,MLA 依赖模型训练得到的投影权重及相应缓存布局,不能仅在服务或推理阶段给普通 checkpoint 打开一个开关来实现。
本文语境解释,未作为独立知识专题收录。
本块新增 13 项
英文原文 10
276 词5. Replace growing cache with fixed state using Hybrid models
Mamba and recurrent linear-attention layers don't store one key and value for every old token. They update a fixed-size state as the sequence grows.
Pure recurrent models keep memory nearly constant with context, but full attention remains better at exact retrieval in many settings. Recent models combine both.
Qwen3-Next has 48 layers arranged as 12 repeated blocks. Each block contains three Gated DeltaNet layers and one full-attention layer. Only the 12 full-attention layers create a standard growing KV cache.
The model card reports 16 query heads, 2 KV heads, and a head dimension of 256 for those attention layers.
The next example compares their memory growth. The attention layer stores one 64-value key and value per token. The recurrent layer keeps one fixed 64-by-64 state.
width = 64
bytes_per_value = 4

attention_values_per_token = 2 * width
recurrent_state_values = width * width

for tokens in [128, 4096]:
    attention_kb = tokens * attention_values_per_token * bytes_per_value // 1024
    recurrent_kb = recurrent_state_values * bytes_per_value // 1024

    print(f"{tokens} tokens")
    print("  attention KV:", attention_kb, "KB")
    print("  recurrent state:", recurrent_kb, "KB")

# Output:
"""
128 tokens
  attention KV: 64 KB
  recurrent state: 16 KB
4096 tokens
  attention KV: 2048 KB
  recurrent state: 16 KB
"""
The attention calculation multiplies storage per token by sequence length. The recurrent calculation does not use tokens at all. Its state remains the same size in both cases.
The example tracks memory only. It does not implement Mamba or Gated DeltaNet. Those architectures use learned update rules to decide what the fixed state retains.
The attention cache grows 32x between the two sequence lengths. The recurrent state remains 16 KB. Hybrid models pay linear cache growth only in their full-attention layers.
中文译文 10
470 字5. 使用混合模型,以固定状态替代不断增长的缓存
Mamba 和循环线性注意力层不会为每个旧 token 存储一个 key 和 value。随着序列增长,它们会更新一个固定大小的状态。
纯循环模型的内存占用几乎不随上下文长度变化,但在许多设置中,完整注意力仍然更擅长精确检索。近期模型将两者结合起来。
Qwen3-Next 有 48 层,排列为 12 个重复模块。每个模块包含三个 Gated DeltaNet 层和一个完整注意力层。只有 12 个完整注意力层会创建标准的、不断增长的 KV 缓存。
模型卡报告称,对于这些注意力层,模型使用 16 个 query 头、2 个 KV 头,以及 256 的头维度。
下一个示例比较它们的内存增长。注意力层每个 token 存储一个包含 64 个值的 key 和一个包含 64 个值的 value。循环层则保留一个固定的 64×64 状态。
width = 64
bytes_per_value = 4

attention_values_per_token = 2 * width
recurrent_state_values = width * width

for tokens in [128, 4096]:
    attention_kb = tokens * attention_values_per_token * bytes_per_value // 1024
    recurrent_kb = recurrent_state_values * bytes_per_value // 1024

    print(f"{tokens} tokens")
    print("  attention KV:", attention_kb, "KB")
    print("  recurrent state:", recurrent_kb, "KB")

# Output:
"""
128 tokens
  attention KV: 64 KB
  recurrent state: 16 KB
4096 tokens
  attention KV: 2048 KB
  recurrent state: 16 KB
"""注意力计算会将每个 token 的存储量乘以序列长度。循环计算完全不使用 token 数量。它的状态在两种情况下都保持相同大小。
该示例只跟踪内存。它没有实现 Mamba 或 Gated DeltaNet。这些架构使用经过学习的更新规则来决定固定状态保留什么。
在这两个序列长度之间,注意力缓存增长了 32 倍。循环状态保持为 16 KB。混合模型只有在其完整注意力层中承担线性的缓存增长。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是章节标题,具体架构和数字见后文。 原文描述的是 Mamba 和循环线性注意力层的一般机制,没有给出具体更新公式。 “许多设置”和“近期模型”是原文的概括;没有限定具体任务或模型范围。 这些结构和层数是原文给出的模型信息;原文未在此处提供外部核验过程。 信息归属于原文所称的模型卡报告;本单元没有给出模型卡链接或其他核验材料。 这里的 64 和 64×64 是示例设定;原文没有在本单元解释它们与上一段模型形状的全部对应关系。 这里只说明代码语言,没有提供其他技术结论。 这是内存增长的示例计算,不是 Mamba 或 Gated DeltaNet 的实现,也未在此声称代码已运行。 该结论针对文中示例所描述的存储计算;没有涉及其他运行时开销。 关于学习到的更新规则的具体形式,原文没有提供实现或公式。 32 倍和 16 KB 来自前述示例;对混合模型的概括不包括其他可能的内存开销。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
混合模型与固定状态
本节转向混合架构,讨论如何通过循环层等机制,用固定大小的状态替代随上下文长度增长的缓存。
本文语境解释,未作为独立知识专题收录。
循环层的固定状态
这类层通过持续更新固定大小的状态来处理更长序列,而不是像标准注意力那样为每个历史 token 保留 key 和 value。
本文语境解释,未作为独立知识专题收录。
循环模型与完整注意力的取舍
循环结构有近似恒定的内存优势,完整注意力则在一些精确检索任务中更有优势,因此混合模型同时采用两类层。
本文语境解释,未作为独立知识专题收录。
Qwen3-Next 的混合层结构
48 层由 12 个相同结构的模块组成,每个模块只有一个完整注意力层,因此会增长的标准 KV 缓存只来自这 12 层。
本文语境解释,未作为独立知识专题收录。
注意力层的形状
该段列出 Qwen3-Next 注意力层的 query 头数、KV 头数和每头维度,为后续内存估算提供形状信息。
本文语境解释,未作为独立知识专题收录。
注意力与循环状态的内存增长
示例将注意力的按 token 增长存储与循环层的固定矩阵状态进行对比。
本文语境解释,未作为独立知识专题收录。
代码语言
该单元标识后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
注意力与循环状态的内存示例
代码按给定宽度和每个值的字节数,分别计算 128 和 4096 个 token 时注意力 KV 的存储量,以及循环状态的固定存储量。原文给出的输出是:注意力 KV 从 64 KB 增长到 2048 KB,而循环状态在两种长度下均为 16 KB。
本文语境解释,未作为独立知识专题收录。
内存是否随序列增长
注意力缓存按序列长度线性累加,而循环状态使用固定大小,因此序列从 128 增长到 4096 时,二者表现不同。
本文语境解释,未作为独立知识专题收录。
示例的范围限制
作者说明示例仅用于说明内存规模,不涉及循环架构实际如何更新状态或筛选信息。
本文语境解释,未作为独立知识专题收录。
混合模型的缓存增长
从 128 到 4096 个 token 是 32 倍增长,注意力缓存也随之增长;固定循环状态不变,因此混合模型的线性缓存部分只来自完整注意力层。
本文语境解释,未作为独立知识专题收录。
本块新增 11 项
英文原文 11
238 词For the Qwen3-Next attention shape, 12 full-attention layers require 3 GB of BF16 KV at 128K context.
Making all 48 layers full attention would raise that growing portion to 12 GB.
Jamba shows the same design choice with a different ratio. It interleaves one attention layer with seven Mamba layers. At 256K context, the Jamba paper reports a 4 GB KV cache, compared with 32 GB for Mixtral.
This layout belongs to the trained model. A serving engine cannot replace arbitrary attention layers with recurrent ones at runtime.
6. Compressed sparse attention
Full attention does two expensive things. It stores a separate KV entry for every earlier token, then reads every stored entry when generating the next token.
Sparse attention changes only the second part.
It reads fewer entries for each new token, but it may still keep the complete cache in memory. That can make generation faster without making the resident KV cache smaller.
Compressed sparse attention focuses on optimizing both parts.
- First, it combines several neighbouring token entries into one compressed entry. It stores that shorter sequence instead of one long-range entry per token.
- Then, for each new token, a selector chooses only the compressed entries that appear most relevant. Attention reads that selected subset.
DeepSeek V4 uses this design.
If the compression factor is m, every m token entries become one stored entry. So a context of n tokens produces roughly n / m compressed entries.
中文译文 11
452 字按照 Qwen3-Next 的注意力形状,在 128K 上下文长度下,12 个完整注意力层需要 3 GB 的 BF16 KV 缓存。
如果让全部 48 层都使用完整注意力,这部分不断增长的存储量将升至 12 GB。
Jamba 展示了相同的设计选择,但比例不同。它每加入一个注意力层,就交错加入七个 Mamba 层。在 256K 上下文长度下,Jamba 论文报告的 KV 缓存为 4 GB,而 Mixtral 为 32 GB。
这种布局属于经过训练的模型。服务引擎不能在运行时任意地将注意力层替换为循环层。
6. 压缩稀疏注意力
完整注意力机制会做两件昂贵的事。它会为每个更早的词元存储一个单独的 KV 条目,然后在生成下一个词元时读取所有已存储的条目。
稀疏注意力只改变第二部分。
它为每个新词元读取更少的条目,但仍可能将完整缓存保存在内存中。这可以让生成更快,却不会让常驻 KV 缓存变小。
压缩稀疏注意力侧重于同时优化这两部分。
- 首先,它将几个相邻的词元条目合并为一个压缩条目。它存储的是更短的序列,而不是为每个词元存储一个较长范围的条目。
- 然后,对于每个新词元,选择器只选择看起来最相关的压缩条目。注意力读取这个选定的子集。
DeepSeek V4 使用了这种设计。
如果压缩因子为 m,那么每 m 个词元条目会变成一个存储条目。因此,包含 n 个词元的上下文会产生大约 n / m 个压缩条目。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
3 GB 是原文给出的数值;本单元未展示计算过程,也未说明 GB 的具体计量口径。 12 GB 是基于原文前一数值的比较结果;它只涉及不断增长的部分。 4 GB 和 32 GB 是原文归属于 Jamba 论文的报告值;原文未在此处说明比较所用的具体配置细节。 原文没有进一步说明如果要改变布局需要哪些训练或转换步骤。 仅凭标题无法确定后续具体方法或结论。 这是作者对完整注意力工作方式的概括;文中未给出具体资源或性能数值。 作者明确限定稀疏注意力只改变读取部分,而非缓存存储部分。 文中使用“可能”,实际效果取决于具体实现;不能据此断言常驻缓存一定不变。 这是作者对该技术目标的概括,尚未在此处说明具体实现细节。 作者描述了压缩方式,但未说明压缩条目的具体表示或信息损失。 “最相关”是原文表述,选择标准和准确性尚待具体实现或实验验证。 这是原文给出的归属;文中未提供进一步的架构证据。 原文使用“大约”,实际数量可能受分组边界等因素影响。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
Qwen3-Next 的 BF16 KV 缓存
该段将 12 个完整注意力层、给定注意力形状和 128K 上下文结合起来,给出 BF16 KV 缓存的估算值。
本文语境解释,未作为独立知识专题收录。
全部使用完整注意力的代价
将完整注意力层从 12 层增加到 48 层,相当于按层数比例扩大不断增长的 KV 缓存部分。
本文语境解释,未作为独立知识专题收录。
Jamba 的注意力与 Mamba 比例
Jamba 通过较少的注意力层和较多的 Mamba 层来限制增长型 KV 缓存;原文用 256K 上下文下的 Jamba 与 Mixtral 数字进行比较。
本文语境解释,未作为独立知识专题收录。
混合布局不能运行时替换
混合架构的层类型和布局是模型训练的一部分,因此服务引擎不能只在部署阶段随意改变层的性质来获得固定状态。
本文语境解释,未作为独立知识专题收录。
压缩稀疏注意力
这是下一节的标题,主题将转向通过压缩或稀疏机制降低注意力相关开销。
本文语境解释,未作为独立知识专题收录。
完整注意力的开销
本段指出完整注意力在 KV 缓存存储和读取两方面都产生开销。
本文语境解释,未作为独立知识专题收录。
稀疏读取
稀疏注意力保留逐条存储的方式,但减少生成时读取的缓存条目。
本文语境解释,未作为独立知识专题收录。
更快但不更省缓存
减少读取量可能降低生成时的工作量,但如果所有条目仍驻留内存,缓存占用不会因此减少。
本文语境解释,未作为独立知识专题收录。
同时优化两部分
该方法同时针对 KV 条目的存储数量和每步注意力读取数量进行优化。
本文语境解释,未作为独立知识专题收录。
合并相邻条目
通过分组压缩相邻词元,缓存中需要存储的条目数量减少。
本文语境解释,未作为独立知识专题收录。
选择相关条目
压缩后,选择器根据当前新词元筛选条目,注意力只处理筛选出的部分。
本文语境解释,未作为独立知识专题收录。
DeepSeek V4 的设计
本段将前述压缩与选择机制归因于 DeepSeek V4。
本文语境解释,未作为独立知识专题收录。
压缩因子
压缩因子 m 表示每组包含的词元条目数,因此压缩后的条目数量约为原数量除以 m。
本文语境解释,未作为独立知识专题收录。
本块新增 13 项
英文原文 12
256 词The model then selects k of those entries for attention. A small sliding window preserves finer detail for the most recent tokens.
At one million tokens, DeepSeek reports that V4-Pro uses 10 percent of the KV cache and 27 percent of the single-token inference FLOPs required by DeepSeek V3.2. V4-Flash goes further at 7 percent of the cache and 10 percent of the FLOPs
These are whole-model results. They include V4’s hybrid attention layout and precision choices, so they should not be read as the isolated effect of compression alone.
The next block isolates the two reductions. Compressing 32 long-range entries in groups of four leaves eight stored entries. If attention selects two of those eight, it reads only two compressed entries for the current step.
full_token_entries = 32
tokens_per_group = 4
selected_entries = 2

compressed_entries = full_token_entries // tokens_per_group

print("full token entries:", full_token_entries)
print("compressed entries stored:", compressed_entries)
print("compressed entries read:", selected_entries)
print("storage reduction:", f"{full_token_entries / compressed_entries:.0f}x")

# Output:
"""
full token entries: 32
compressed entries stored: 8
compressed entries read: 2
storage reduction: 4x
"""
Dividing 32 tokens into groups of four creates eight compressed entries. That is the storage reduction. Selecting two of those eight entries is the separate attention-work reduction.
The cache now holds eight long-range entries instead of 32. Attention reads two of them. A small local window separately preserves recent token detail.
This technique has to be built into the model and training process. A serving engine cannot convert an existing full-attention model into compressed sparse attention by changing a cache setting.
中文译文 12
442 字随后,模型会从这些条目中选择 k 个用于注意力计算。一个较小的滑动窗口会为最近的词元保留更细致的细节。
在一百万个词元的情况下,DeepSeek 报告称,与 DeepSeek V3.2 所需的单词元推理 FLOPs 相比,V4-Pro 使用了 KV 缓存的 10% 和单词元推理 FLOPs 的 27%。V4-Flash 更进一步,分别为缓存的 7% 和 FLOPs 的 10%。
这些是整个模型的结果。其中包含 V4 的混合注意力布局和精度选择,因此不应将其解读为压缩单独带来的效果。
下一部分将这两种减少分别隔离出来。将 32 个长程条目按每组四个进行压缩后,会留下八个存储条目。如果注意力从这八个条目中选择两个,那么当前步骤只会读取两个压缩条目。
full_token_entries = 32
tokens_per_group = 4
selected_entries = 2

compressed_entries = full_token_entries // tokens_per_group

print("full token entries:", full_token_entries)
print("compressed entries stored:", compressed_entries)
print("compressed entries read:", selected_entries)
print("storage reduction:", f"{full_token_entries / compressed_entries:.0f}x")

# Output:
"""
full token entries: 32
compressed entries stored: 8
compressed entries read: 2
storage reduction: 4x
"""将 32 个词元分成每组四个,会创建八个压缩条目。这就是存储减少。再从这八个条目中选择两个,则是另一种独立的注意力工作量减少。
现在,缓存中保存的是八个长程条目,而不是 32 个。注意力会读取其中两个。一个较小的局部窗口则单独保留最近词元的细节。
这项技术必须构建在模型和训练过程中。服务引擎不能仅通过修改缓存设置,就把一个现有的完整注意力模型转换为压缩稀疏注意力模型。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
文中未定义 k 的取值,也未说明滑动窗口的具体大小或实现方式。 这些数字是 DeepSeek 报告的结果;原文未在此处提供测量条件或独立核验。 作者明确限制了这些数字的归因范围;压缩的独立贡献尚未由这些结果单独确定。 这是说明机制的示例,不代表所有模型或配置的实际数值。 这里只提供语言标记,未涉及代码执行结果。 代码展示的是整数分组和比例计算示例;这里只作文字解释,不据此声称已运行或核验输出。 作者将两种减少视为相互独立的效果;示例中的比例不应直接推广到其他设置。 这是对前述示例机制的总结;局部窗口的具体配置未给出。 作者明确否定了仅修改缓存设置即可完成转换的说法;文中未讨论所有可能的工程替代方案。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
选择与局部窗口
模型从压缩条目中读取选定的 k 个,同时通过局部窗口保留近期词元的更细粒度信息。
本文语境解释,未作为独立知识专题收录。
报告的缓存与 FLOPs
该段给出一百万词元上下文下,V4-Pro 和 V4-Flash 相对于 DeepSeek V3.2 的缓存与单词元推理 FLOPs 比例。
本文语境解释,未作为独立知识专题收录。
整体模型结果
报告的比例同时受到模型注意力布局和数值精度等因素影响,不能简单归因于压缩。
本文语境解释,未作为独立知识专题收录。
隔离两种减少
示例分别展示了分组压缩如何减少存储条目,以及选择子集如何减少当前步骤的读取量。
本文语境解释,未作为独立知识专题收录。
代码语言
该单元标示后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
压缩条目示例代码
代码用 32 个完整词元条目、每组 4 个条目和选择 2 个条目的示例,计算压缩后存储的条目数,并打印存储减少倍数。代码中还以注释形式列出了预期输出。
本文语境解释,未作为独立知识专题收录。
存储与读取的区别
本段区分了压缩带来的缓存存储减少和选择子集带来的注意力读取工作量减少。
本文语境解释,未作为独立知识专题收录。
压缩后的缓存
压缩减少长程条目的存储数量,选择机制减少每步读取数量,局部窗口负责保留近期细节。
本文语境解释,未作为独立知识专题收录。
需要模型与训练支持
压缩稀疏注意力涉及模型结构和训练过程,因此不是服务阶段单独调整缓存参数就能实现的。
本文语境解释,未作为独立知识专题收录。
本块新增 9 项
英文原文 13
195 词7. Query-aware sparse reads
The previous technique reduced both storage and attention work.
Sometimes, changing the model architecture is not an option. We may still want to reduce how much cache each decode step reads.
Recall what happens while the model generates a token. The new token produces a query, which acts like a search signal. Full attention compares it with every stored key. A long prompt therefore forces the GPU to load a large cache repeatedly.
Quest is a technique that reduces those reads without deleting any KV entries.
- It divides the cache into pages.
- A page is a small group of neighbouring token entries.
- Each page also stores the minimum and maximum key values found inside it.
For every new query, Quest scores these short page summaries first. It then loads only the pages with the highest scores. The full cache remains stored because a page ignored now may matter later.
The Quest paper reports up to 7.03x lower self-attention latency. Its complete inference system reached up to 2.23x speedup.
The example below uses four pages. Each page contains two keys. A key has only two numbers here, which keeps the scoring visible.
中文译文 13
353 字7. 面向查询的稀疏读取
前一种技术同时减少了存储和注意力工作量。
有时,改变模型架构并不是一个可选项。我们仍可能希望减少每个解码步骤读取的缓存量。
回想一下模型生成一个词元时会发生什么。新词元会产生一个查询,它像一个搜索信号。完整注意力会将它与每个已存储的键进行比较。因此,较长的提示会迫使 GPU 反复加载大量缓存。
Quest 是一种在不删除任何 KV 条目的情况下减少这些读取的方法。
- 它将缓存划分为多个页。
- 一页是由相邻词元条目组成的小组。
- 每个页面还会存储其中发现的键值的最小值和最大值。
对于每个新查询,Quest 会先为这些简短的页面摘要评分。然后,它只加载得分最高的页面。完整缓存仍会被存储,因为当前被忽略的页面之后可能会变得重要。
Quest 论文报告称,自注意力延迟最高降低了 7.03 倍。其完整推理系统的加速最高达到 2.23 倍。
下面的示例使用四个页面。每个页面包含两个键。这里的键只有两个数字,这让评分过程清晰可见。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题对应后续内容;本单元本身未提供方法细节。 这是对前文机制的总结,具体收益仍受实现和配置影响。 原文使用“有时”和“可能”,没有说明哪些场景必然无法修改架构。 这是作者对完整注意力读取过程的解释;实际 GPU 开销还可能受硬件和实现影响。 作者只说明了目标和基本限制,未在本单元中给出性能结果。 本段未说明页的大小或具体布局。 作者只给出概念性定义,未规定每页包含的确切条目数量。 这是原文对 Quest 页面摘要机制的描述;其具体实现细节未在此处展开。 原文声称这种方法会选择高分页面,但没有在此处说明选择数量或评分误差。 这些是原文归属于 Quest 论文的报告数字;适用条件和核验范围未在本文中给出。 这是用于说明机制的简化示例,不代表实际系统的完整数据规模。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
面向查询的稀疏读取
该标题引出另一种方法:在不改变模型架构的前提下,减少每次解码读取的缓存量。
本文语境解释,未作为独立知识专题收录。
前一种技术的效果
本段回顾压缩稀疏注意力同时降低缓存存储量与注意力读取工作量。
本文语境解释,未作为独立知识专题收录。
不改变架构的需求
当无法修改模型架构时,仍可尝试从服务读取路径入手,降低每步解码访问的缓存量。
本文语境解释,未作为独立知识专题收录。
查询驱动的缓存读取
新词元产生的查询需要与已存储的键比较;在完整注意力下,长提示会导致每个生成步骤访问大量缓存。
本文语境解释,未作为独立知识专题收录。
Quest 方法
Quest 的目标是保留完整 KV 缓存,同时通过选择性读取减少每个解码步骤访问的数据。
本文语境解释,未作为独立知识专题收录。
划分页
Quest 先把缓存组织成页,为后续按页筛选和读取提供单位。
本文语境解释,未作为独立知识专题收录。
页的定义
缓存页以相邻词元条目为一组,将连续的缓存内容组织在一起。
本文语境解释,未作为独立知识专题收录。
页面范围摘要
页面除了保存键值本身,还保存每个维度的最小值和最大值,作为页面内容的简短摘要。
本文语境解释,未作为独立知识专题收录。
按查询选择页面
Quest 先用页面摘要估计相关性,再读取高分页面,以减少当前查询需要处理的数据;未选页面仍保留在缓存中。
本文语境解释,未作为独立知识专题收录。
报告的加速效果
这两组数字分别描述自注意力部分的延迟变化和完整推理系统的加速效果。
本文语境解释,未作为独立知识专题收录。
四页面示例
示例缩小了页面数量、每页键数量和键的维度,以便直接观察页面评分。
本文语境解释,未作为独立知识专题收录。
本块新增 11 项
英文原文 14
236 词import numpy as np
pages = np.array([
[[1, 0], [2, 1]],
[[5, 1], [4, 2]],
[[0, 6], [1, 5]],
[[-2, -1], [-1, 0]],
])
query = np.array([1.0, 0.5])
page_min = pages.min(axis=1)
page_max = pages.max(axis=1)
page_scores = np.maximum(query * page_min, query * page_max).sum(axis=1)
selected_pages = np.argsort(page_scores)[-2:]
for page, score in enumerate(page_scores):
print(f"page {page} score: {score:.1f}")
print("selected pages:", np.sort(selected_pages).tolist())
print("KV entries read:", len(selected_pages) * 2, "of", pages.size // 2)
print("KV entries still stored:", pages.size // 2)
# Output:
"""
page 0 score: 2.5
page 1 score: 6.0
page 2 score: 4.0
page 3 score: -1.0
selected pages: [1, 2]
KV entries read: 4 of 8
KV entries still stored: 8
"""The pages array contains eight keys in total. The next two lines create one minimum and one maximum summary per page. Quest uses similar summaries to estimate a page's best possible attention score.
The query prefers large values in both key dimensions. Pages 1 and 2 receive the highest scores, so the example reads their four keys. It leaves the other four keys untouched during this step.
If you notice the last line, the step reads four entries, but all eight remain resident. Quest reduces cache traffic and attention work. It does not reduce the memory needed to hold the full cache.
In practice, Quest uses many-dimensional keys and dedicated GPU code. It also repeats the selection for every query.
中文译文 14
338 字import numpy as np
pages = np.array([
[[1, 0], [2, 1]],
[[5, 1], [4, 2]],
[[0, 6], [1, 5]],
[[-2, -1], [-1, 0]],
])
query = np.array([1.0, 0.5])
page_min = pages.min(axis=1)
page_max = pages.max(axis=1)
page_scores = np.maximum(query * page_min, query * page_max).sum(axis=1)
selected_pages = np.argsort(page_scores)[-2:]
for page, score in enumerate(page_scores):
print(f"page {page} score: {score:.1f}")
print("selected pages:", np.sort(selected_pages).tolist())
print("KV entries read:", len(selected_pages) * 2, "of", pages.size // 2)
print("KV entries still stored:", pages.size // 2)
# Output:
"""
page 0 score: 2.5
page 1 score: 6.0
page 2 score: 4.0
page 3 score: -1.0
selected pages: [1, 2]
KV entries read: 4 of 8
KV entries still stored: 8
"""pages 数组总共包含八个键。接下来的两行代码为每个页面创建一个最小值摘要和一个最大值摘要。Quest 使用类似的摘要来估计一个页面可能达到的最高注意力分数。
查询偏好两个键维度中的较大值。页面 1 和页面 2 获得最高分,因此示例读取了它们的四个键。在这一步中,另外四个键没有被触碰。
如果你注意最后一行,就会发现这一步读取了四个条目,但八个条目仍然全部驻留。Quest 减少了缓存流量和注意力计算量。它并没有减少容纳完整缓存所需的内存。
在实际应用中,Quest 使用多维键和专用 GPU 代码。它还会针对每个查询重复执行选择过程。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
仅为代码语言标签。 代码中的输出是原文提供的示例结果;此处不声称已运行或独立核验。示例只统计原始键载荷,未涉及其他存储开销。 原文将这种估计描述为与 Quest 类似,但没有证明该摘要一定等于实际最高分。 这是该示例数据和查询下的结论;不能据此推断所有查询都会选择相同页面。 原文明确区分缓存流量、注意力工作量和缓存驻留内存;具体节省比例未在此处给出。 原文未说明专用 GPU 代码的具体实现或重复选择的额外成本。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
Python 标记
该单元标示后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
页面评分代码
代码先构造四个页面及查询向量,计算每页各维度的最小值和最大值,再用查询与这些边界的乘积估算页面分数。随后选取得分最高的两个页面,打印各页分数、读取的键数量和仍存储的键数量。代码末尾给出了预期输出,其中页面 1 和页面 2 被选中。
本文语境解释,未作为独立知识专题收录。
页面摘要的构造
数组中共有八个键;最小值和最大值把每页的范围压缩成摘要,用于估计页面的潜在注意力得分。
本文语境解释,未作为独立知识专题收录。
高分页面读取
由于查询向量的两个分量为正,较大的键值会提高估计分数,所以示例选择了页面 1 和页面 2。
本文语境解释,未作为独立知识专题收录。
减少读取而非存储
选择页面只减少当前步骤实际读取和处理的数据量,未删除未选页面,因此完整缓存仍占用内存。
本文语境解释,未作为独立知识专题收录。
实际部署方式
实际系统比示例使用更高维的键,并通过 GPU 专用代码执行;页面选择不是只做一次,而是随每个查询重复。
本文语境解释,未作为独立知识专题收录。
本块新增 6 项
英文原文 15
285 词8. Quantization
Quest keeps every KV entry and skips some reads. Quantization takes another route. It keeps every entry but stores each number with fewer bits.
Keys and values normally contain floating-point numbers. BF16 stores each number with 16 bits. FP8 uses 8 bits, so its raw payload is roughly half as large. A 4-bit format cuts the payload to 25%.
Quantization maps many original numbers onto a smaller set of allowed values. A scale controls the gap between those values. The engine stores the small integer code and enough scale information to interpret it later
The choice of scale affects accuracy. One extreme value can make a shared scale too wide. Most ordinary values then get rounded too aggressively.
KIVI handles keys and values differently. It groups key values by channel, which means the same feature across tokens. It groups value-cache numbers by token. The KIVI paper reports 2.6x lower peak memory and up to 4x larger batches with its 2-bit cache
The small example below shows the basic mapping. It converts six BF16-style values into signed 4-bit codes. It then converts those codes back into approximate values.
import numpy as np

values = np.array([-1.0, -0.55, -0.10, 0.25, 0.60, 1.0])
bits = 4
largest_code = 2 ** (bits - 1) - 1
scale = np.max(np.abs(values)) / largest_code

codes = np.rint(values / scale)
codes = np.clip(codes, -largest_code, largest_code).astype(np.int8)
restored = codes * scale

print("original values:", values.tolist())
print("4-bit codes:", codes.tolist())
print("restored values:", np.round(restored, 3).tolist())
print("raw payload:", len(values) * 16, "bits ->", len(values) * 4, "bits")

# Output:
"""
original values: [-1.0, -0.55, -0.1, 0.25, 0.6, 1.0]
4-bit codes: [-7, -4, -1, 2, 4, 7]
restored values: [-1.0, -0.571, -0.143, 0.286, 0.571, 1.0]
raw payload: 96 bits -> 24 bits
"""
中文译文 15
438 字8. 量化
Quest 保留每个 KV 条目,但跳过部分读取。量化采取另一条路线。它保留每个条目,但用更少的位存储每个数字。
键和值通常包含浮点数。BF16 用 16 位存储每个数。FP8 使用 8 位,因此其原始载荷大约只有一半大小。4 位格式会将载荷降至 25%。
量化会将许多原始数字映射到一组更小的允许值上。一个缩放因子控制这些值之间的间隔。引擎存储较小的整数代码以及足够的缩放信息,以便之后解释它。
缩放因子的选择会影响准确性。一个极端值可能使共享缩放因子覆盖过宽的范围。这样一来,大多数普通值就会被过度舍入。
KIVI 对键和值采用不同的处理方式。它按通道对键值进行分组,也就是跨 token 使用同一特征。它按 token 对值缓存中的数字进行分组。KIVI 论文报告称,使用其 2 位缓存时,峰值内存降低了 2.6 倍,批量大小最高增加了 4 倍。
下面的小示例展示基本映射。它将六个类似 BF16 的值转换为有符号 4 位代码。然后再将这些代码转换回近似值。
import numpy as np

values = np.array([-1.0, -0.55, -0.10, 0.25, 0.60, 1.0])
bits = 4
largest_code = 2 ** (bits - 1) - 1
scale = np.max(np.abs(values)) / largest_code

codes = np.rint(values / scale)
codes = np.clip(codes, -largest_code, largest_code).astype(np.int8)
restored = codes * scale

print("original values:", values.tolist())
print("4-bit codes:", codes.tolist())
print("restored values:", np.round(restored, 3).tolist())
print("raw payload:", len(values) * 16, "bits ->", len(values) * 4, "bits")

# Output:
"""
original values: [-1.0, -0.55, -0.1, 0.25, 0.6, 1.0]
4-bit codes: [-7, -4, -1, 2, 4, 7]
restored values: [-1.0, -0.571, -0.143, 0.286, 0.571, 1.0]
raw payload: 96 bits -> 24 bits
"""上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是章节标题及其主题概述。 原文只比较两种路线的基本区别,没有讨论两者结合时的效果。 这里的比例只针对原始载荷;未计入缩放信息、元数据或其他实际存储开销。 原文说明了基本映射关系,但没有指定具体量化格式或缩放信息的存储布局。 原文描述的是量化中的一般权衡,没有给出误差阈值或具体数据。 这些数字是原文归属于 KIVI 论文的报告;实验条件和“降低 2.6 倍”的具体定义未在此处说明。 示例使用的是简化的单一缩放因子,不等同于完整缓存量化方案。 仅为代码语言标签。 代码中的输出是原文提供的示例结果;此处不声称已运行或独立核验。最后的位数比较只计算六个数的原始载荷。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
量化
本节转向另一种降低 KV 缓存存储载荷的方法:保留所有条目,但用更少的位表示每个数。
本文语境解释,未作为独立知识专题收录。
量化与跳过读取
Quest 通过少读数据降低工作量,而量化不跳过条目,改为压缩每个数的表示,以降低存储载荷。
本文语境解释,未作为独立知识专题收录。
不同位宽的载荷
在只比较每个数的原始位数时,FP8 相比 BF16 使用一半位数,4 位格式使用四分之一位数。
本文语境解释,未作为独立知识专题收录。
量化映射
量化用离散的整数代码近似原始数值,缩放因子决定代码对应的数值间隔,恢复时需要该缩放信息。
本文语境解释,未作为独立知识专题收录。
缩放因子与误差
如果多个值共享一个被极端值拉大的范围,量化级距会变粗,普通值的近似误差可能增大。
本文语境解释,未作为独立知识专题收录。
KIVI 的分组量化
KIVI 对键按通道分组、对值按 token 分组,使两类数据使用不同的量化组织方式;原文还列出其 2 位缓存的内存和批量结果。
本文语境解释,未作为独立知识专题收录。
四位量化示例
示例用六个数展示从原始值到有符号 4 位代码,再从代码恢复近似值的过程。
本文语境解释,未作为独立知识专题收录。
Python 标记
该单元标示后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
四位量化代码
代码创建六个数,使用 4 位有符号代码的最大正代码值计算缩放因子。它将数值除以缩放因子并四舍五入、裁剪到允许范围,再乘回缩放因子得到恢复值,同时比较原始和量化后的原始载荷位数。代码末尾给出了预期输出。
本文语境解释,未作为独立知识专题收录。
本块新增 9 项
英文原文 16
229 词Signed 4-bit storage provides codes from -7 through 7 in this example. Dividing by scale maps each original value to a code. Multiplying by the same scale produces the approximate value used during attention.
As you may have noticed, the restored values are close, but not identical. That rounding difference is quantization error. The final line counts only the six stored values. A real cache also stores scale metadata.
The example uses one scale for all six values. KIVI uses smaller groups because each group can fit its own numerical range. This usually reduces rounding error, though it requires more scale metadata.
If you use vLLM, it exposes FP8 cache storage directly:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct
vllm serve "$MODEL_ID" --kv-cache-dtype fp8
The first line defines the model name. The second starts a vLLM server and asks it to store the KV cache in FP8. This command keeps running because it launches the inference server.
Recent vLLM versions can also leave selected layers in their native type. This is useful when a sliding-window layer proves more sensitive:
MODEL_ID=google/gemma-3-4b-it
vllm serve "$MODEL_ID" \
  --kv-cache-dtype fp8 \
  --kv-cache-dtype-skip-layers sliding_window
This version leaves sliding-window layers in their original format. It quantizes the remaining cache layers. The option helps when those local-attention layers lose too much accuracy under FP8.
Quantization preserves every token position. The next technique reduces memory by removing positions instead.
中文译文 16
398 字在这个示例中,有符号 4 位存储提供从 -7 到 7 的代码。将每个原始值除以缩放因子,就会把它映射到一个代码。再乘以同一个缩放因子,就会得到注意力过程中使用的近似值。
正如你可能已经注意到的,恢复值很接近,但并不完全相同。这种舍入差异就是量化误差。最后一行只计算了六个存储值。真实缓存还会存储缩放元数据。
示例对六个值使用一个缩放因子。KIVI 使用更小的分组,因为每个分组都可以适应自己的数值范围。这通常会减少舍入误差,但需要更多缩放元数据。
如果你使用 vLLM,它会直接提供 FP8 缓存存储:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct
vllm serve "$MODEL_ID" --kv-cache-dtype fp8第一行定义模型名称。第二行启动 vLLM 服务器,并要求它以 FP8 存储 KV 缓存。该命令会持续运行,因为它启动了推理服务器。
近期版本的 vLLM 还可以让选定的层保留其原生类型。当滑动窗口层被证明更加敏感时,这很有用:
MODEL_ID=google/gemma-3-4b-it
vllm serve "$MODEL_ID" \
  --kv-cache-dtype fp8 \
--kv-cache-dtype-skip-layers sliding_window这个版本会让滑动窗口层保留原始格式,并量化其余的缓存层。当这些局部注意力层在 FP8 下损失过多精度时,该选项会有所帮助。
量化会保留每个令牌位置。下一种技术则通过移除位置来减少内存。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这里的代码范围是该示例所采用的表示方式;原文没有讨论其他 4 位格式的范围。 原文确认存在量化误差和额外元数据,但没有量化元数据的具体大小。 原文使用“通常”而非绝对保证,且未给出具体误差或元数据增量。 此处只有引导语,具体用法尚未在给定材料中出现。 仅为代码语言标签;给定材料中未包含其后的命令内容。 原文仅说明命令的用途,不代表命令已执行或服务已验证可用。 这是对命令行为的文字说明;原文没有提供实际运行结果。 原文将该功能归因于近期 vLLM 版本,但未指明具体版本,也未提供敏感性测试结果。 这只是代码块的语言标签,不包含可核验的运行结果。 原文说明该选项的意图,但未说明具体 vLLM 版本或实际执行结果。 “有所帮助”是条件性判断;原文没有给出精度损失阈值或实测数据。 这是原文对两种技术差异的概括,未比较它们在具体模型上的效果。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
代码与恢复值
代码范围和缩放因子共同定义了量化值;恢复时使用相同缩放因子,将离散代码还原为近似数值。
本文语境解释,未作为独立知识专题收录。
量化误差与元数据
离散化和舍入使恢复值与原值产生差异;示例的载荷统计没有包含实际缓存所需的缩放元数据。
本文语境解释,未作为独立知识专题收录。
分组缩放
缩小分组范围可以让缩放因子更贴合组内数值,从而通常降低舍入误差;代价是要为更多分组保存缩放信息。
本文语境解释,未作为独立知识专题收录。
vLLM 的 FP8 存储
原文引出 vLLM 中直接使用 FP8 作为缓存存储格式的配置或命令示例。
本文语境解释,未作为独立知识专题收录。
Bash 标记
该单元标示后续代码或命令使用 Bash。
本文语境解释,未作为独立知识专题收录。
以 FP8 启动 vLLM
这段代码设置模型标识,并启动使用 FP8 存储 KV 缓存的 vLLM 服务。
本文语境解释,未作为独立知识专题收录。
命令的运行方式
这一段解释了前一段启动命令中模型变量、KV 缓存数据类型和持续运行行为之间的关系。
本文语境解释,未作为独立知识专题收录。
跳过敏感层的量化
作者引出一种混合处理方式:大部分缓存使用 FP8,而对可能更容易受影响的滑动窗口层保留原始数据类型。
本文语境解释,未作为独立知识专题收录。
Shell 示例语言标记
这是后续命令代码块使用的 Bash 语言标记。
本文语境解释,未作为独立知识专题收录。
保留滑动窗口层类型
这段代码启动 Gemma 模型的 vLLM 服务,将 KV 缓存类型设为 FP8,并指定跳过滑动窗口层。
本文语境解释,未作为独立知识专题收录。
局部注意力层的精度保护
这一段说明跳过指定层后的结果:滑动窗口层不改变格式,其余缓存层进行量化,目的是降低局部注意力层可能出现的精度损失。
本文语境解释,未作为独立知识专题收录。
从量化转向位置移除
作者区分两种压缩思路:量化降低每个缓存项的存储成本,但不删除位置;驱逐则直接减少保留的位置数量。
本文语境解释,未作为独立知识专题收录。
本块新增 12 项
英文原文 17
202 词9. Eviction
Quantization keeps all token positions. That may still be too large for a long context. Eviction sets a fixed position budget and discards entries outside it.
The difficult question is which positions should not be evicted. Recent tokens often matter because they contain the current conversation. Older tokens may still carry instructions, facts, or tool results needed later.
H2O is a technique that keeps recent positions and older heavy hitters. A heavy hitter is a token that has accumulated high attention during earlier steps. Once H2O evicts another token, its KV entry is no longer available.
Other methods estimate importance differently. SnapKV studies attention near the end of the input prompt. It uses that observation window to choose prompt positions before generation.
PyramidKV gives lower layers larger budgets and higher layers smaller ones, based on the attention patterns reported by its authors.
SnapKV reports 8.2x higher memory efficiency and 3.6x faster generation with 16K-token inputs. PyramidKV reports matching full-cache performance while retaining 12 percent of the cache in its LongBench experiments.
The following example takes a snapshot after ten tokens. Their scores represent attention accumulated during earlier decode steps. The cache can retain only six positions, including the latest two.
中文译文 17
384 字9. 驱逐
量化会保留所有令牌位置。对于长上下文,这仍然可能过大。驱逐设定一个固定的位置预算,并丢弃超出该预算的条目。
困难的问题是哪些位置不应被驱逐。最近的令牌通常很重要,因为它们包含当前对话。较早的令牌仍可能携带之后需要的指令、事实或工具结果。
H2O 是一种保留最近位置和较早的重头令牌的技术。重头令牌是指在前面的步骤中累积了较高注意力的令牌。一旦 H2O 驱逐了另一个令牌,该令牌的 KV 条目就不再可用。
其他方法以不同方式估计重要性。SnapKV 研究输入提示末尾附近的注意力,并利用这个观察窗口在生成前选择提示中的位置。
PyramidKV 根据其作者报告的注意力模式,为较低层提供更大的预算,为较高层提供更小的预算。
在 16K 令牌输入下,SnapKV 报告了高 8.2 倍的内存效率和快 3.6 倍的生成速度。PyramidKV 报告称,在其 LongBench 实验中,仅保留 12% 的缓存即可达到与完整缓存相当的性能。
下面的示例在十个令牌之后获取一个快照。它们的分数表示此前解码步骤中累积的注意力。缓存最多只能保留六个位置,其中包括最近的两个位置。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题标记了第九节,原文未在此处给出更具体的范围限定。 原文说明了机制,但未说明预算如何设定或删除后对任务质量的普遍影响。 “通常很重要”是经验性表述;原文没有给出适用任务或量化证据。 原文以历史注意力作为重要性依据,但未说明所有任务中该指标都可靠。 原文只概述方法逻辑,没有说明观察窗口大小或选择算法的完整细节。 该分配依据归于作者报告的注意力模式;原文未提供独立核验或具体预算比例。 这些数字是作者报告的结果,适用于原文所述的 16K 输入或 LongBench 实验条件;原文未提供实验配置、基线细节或独立复现结果。 这是用于展示选择规则的简化示例,不等同于完整的 H2O 实现。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
驱逐
本节讨论通过删除部分 KV 缓存位置来控制长上下文下的内存使用。
本文语境解释,未作为独立知识专题收录。
固定位置预算
驱逐不同于只改变数据精度的量化:它限制缓存可保留的位置总数,并删除预算之外的缓存条目。
本文语境解释,未作为独立知识专题收录。
选择保留哪些位置
缓存位置的重要性并不只由新旧决定:最新内容可能关联当前对话,而早期内容也可能包含未来推理所需的信息。
本文语境解释,未作为独立知识专题收录。
H2O:保留近期与重头令牌
H2O 将缓存分成近期位置和根据历史注意力确定的重头令牌,并在预算不足时移除其他令牌。被移除位置的 KV 信息不能继续用于后续计算。
本文语境解释,未作为独立知识专题收录。
SnapKV 的位置选择
SnapKV 不直接沿用 H2O 的重头令牌定义,而是观察提示末尾附近的注意力,用于生成开始前的缓存位置选择。
本文语境解释,未作为独立知识专题收录。
PyramidKV 的分层预算
PyramidKV 按网络层次分配缓存预算:底层保留更多位置,高层保留更少位置。
本文语境解释,未作为独立知识专题收录。
报告的效率与性能结果
这一段列出两种方法各自报告的实验结果:SnapKV 强调内存效率和生成速度,PyramidKV 强调较低缓存占用下的性能保持。
本文语境解释,未作为独立知识专题收录。
六位置缓存示例
示例使用十个位置的历史注意力分数,在固定预算为六的情况下强制保留最近两个位置,再从较早位置中选择其余位置。
本文语境解释,未作为独立知识专题收录。
本块新增 8 项
英文原文 18
225 词scores = [9.0, 0.2, 4.0, 0.1, 0.3, 6.0, 0.2, 0.4, 0.1, 0.2]
budget = 6
recent_count = 2
positions = list(range(len(scores)))
recent = positions[-recent_count:]
older = positions[:-recent_count]
heavy_hitter_count = budget - recent_count
heavy_hitters = sorted(
older,
key=lambda position: scores[position],
reverse=True,
)[:heavy_hitter_count]
retained = sorted(heavy_hitters + recent)
print("heavy hitters:", sorted(heavy_hitters))
print("recent positions:", recent)
print("retained positions:", retained)
print("cache entries:", len(retained), "of", len(scores))
# Output:
"""
heavy hitters: [0, 2, 5, 7]
recent positions: [8, 9]
retained positions: [0, 2, 5, 7, 8, 9]
cache entries: 6 of 10
"""Positions 8 and 9 are retained because they are the newest. Four slots remain. The sort selects positions 0, 2, 5, and 7 because they have the largest scores among older tokens.
The union of those two groups produces the final six-position cache. Positions 1, 3, 4, and 6 are discarded.
Real H2O updates its heavy-hitter statistics as generation proceeds. This smaller example starts with the accumulated scores so the selection rule remains visible.
That said, eviction needs a cautious evaluation. Importance changes across turns. A tool result that receives little attention now may become necessary after several more calls. System instructions and delimiters can also be disproportionately important.
Eviction evaluations should therefore use complete agent traces and delayed references. They should also include structured prompts. A good Needle-in-a-Haystack score does not cover those cases.
中文译文 18
343 字scores = [9.0, 0.2, 4.0, 0.1, 0.3, 6.0, 0.2, 0.4, 0.1, 0.2]
budget = 6
recent_count = 2
positions = list(range(len(scores)))
recent = positions[-recent_count:]
older = positions[:-recent_count]
heavy_hitter_count = budget - recent_count
heavy_hitters = sorted(
older,
key=lambda position: scores[position],
reverse=True,
)[:heavy_hitter_count]
retained = sorted(heavy_hitters + recent)
print("heavy hitters:", sorted(heavy_hitters))
print("recent positions:", recent)
print("retained positions:", retained)
print("cache entries:", len(retained), "of", len(scores))
# Output:
"""
heavy hitters: [0, 2, 5, 7]
recent positions: [8, 9]
retained positions: [0, 2, 5, 7, 8, 9]
cache entries: 6 of 10
"""位置 8 和 9 因为最新而被保留。还剩四个槽位。排序选择了位置 0、2、5 和 7,因为它们在较早令牌中拥有最高分数。
这两组位置的并集产生了最终的六位置缓存。位置 1、3、4 和 6 被丢弃。
真实的 H2O 会随着生成进行而更新其重头令牌统计。这个更小的示例从累积分数开始,因此选择规则仍然清晰可见。
话虽如此,驱逐仍需要谨慎评估。重要性会在不同轮次之间变化。当前很少获得注意力的工具结果,可能在之后几次调用后变得必不可少。系统指令和分隔符也可能具有不成比例的重要性。
因此,驱逐评估应使用完整的智能体轨迹和延迟引用。评估还应包含结构化提示。一个良好的“大海捞针”分数并不能覆盖这些情况。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这只是代码块的语言标签,不包含运行或核验结果。 原文将输出作为示例展示;未声称代码已在当前环境运行。 结论仅适用于前一示例给出的分数和预算。 这是对示例选择规则的直接推导,不代表所有驱逐算法都使用相同规则。 原文明确区分了示例与真实实现;示例没有展示动态更新过程。 这些是评估时需要考虑的风险提示,原文没有量化其发生频率或影响程度。 原文提出评估建议,但没有定义完整轨迹、延迟引用或结构化提示的具体测试标准。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
Python 示例语言标记
这是后续示例代码块使用的 Python 语言标记。
本文语境解释,未作为独立知识专题收录。
按分数保留缓存位置
代码将最近位置固定保留,并从较早位置中按分数从高到低选择重头位置,最终形成六个缓存位置。代码末尾还给出了预期输出。
本文语境解释,未作为独立知识专题收录。
示例中的选择结果
预算中的两个槽位预留给最近位置,其余四个槽位按较早位置的分数排序后分配。
本文语境解释,未作为独立知识专题收录。
形成最终缓存
将固定保留的最近位置与按分数选出的较早位置合并,就得到最终缓存;未入选的四个位置被移除。
本文语境解释,未作为独立知识专题收录。
简化示例与真实 H2O
示例直接使用已经累积的分数来展示筛选过程,而真实 H2O 会在生成过程中持续更新重要性统计。
本文语境解释,未作为独立知识专题收录。
驱逐的风险
缓存位置的重要性是动态的,早期看似不重要的信息可能在后续多轮交互中重新发挥作用,因此简单依据当前注意力进行删除存在风险。
本文语境解释,未作为独立知识专题收录。
更完整的驱逐评估
作者建议评估不仅测试即时检索,还要覆盖完整多轮轨迹、较晚才被引用的信息以及结构化提示,以检验被删除内容是否在后续变得重要。
本文语境解释,未作为独立知识专题收录。
本块新增 7 项
英文原文 19
192 词 · 1 张图10. Paging
So far, we have looked at what one request stores or reads. Paging solves a different problem: how the serving engine allocates cache memory across many requests.
A simple allocator may reserve one continuous memory region per request. It often reserves enough space for the request's maximum length. Shorter requests leave part of that region unused. Free space also gets split into gaps as requests finish.
PagedAttention divides GPU cache memory into equal-sized blocks. Each block holds KV entries for a fixed number of tokens. A request can use blocks found anywhere in the shared pool, so its blocks do not need to lie next to each other.
Avi Chawla@_avichawla·Mar 11 ArticlePaged Attention in LLMs, clearly explained!When you’re serving LLMs at scale, memory becomes your bottleneck before compute does.
The problem isn’t a lack of GPU memory; it’s how inefficiently we use it.
Let’s understand why this happens and...176KWhen a request finishes, the allocator returns its blocks to the pool. Another request can reuse them immediately. The PagedAttention paper reports near-zero KV cache waste and 2x to 4x higher throughput than the systems tested.
中文译文 19
338 字10. 分页
到目前为止,我们讨论的是一个请求存储或读取什么。分页解决的是另一个问题:服务引擎如何在多个请求之间分配缓存内存。
简单的分配器可能会为每个请求预留一段连续的内存区域。它通常会按照请求的最大长度预留足够的空间。较短的请求会使该区域的一部分闲置。随着请求完成,空闲空间也会被分割成一个个间隙。
PagedAttention 将 GPU 缓存内存划分为大小相等的块。每个块存放固定数量 token 的 KV 条目。请求可以使用共享池中任意位置的块,因此其各个块不必彼此相邻。
Avi Chawla@_avichawla·3 月 11 日文章清晰解释 LLM 中的分页注意力!当你大规模提供 LLM 服务时,内存会先于计算成为瓶颈。
问题不在于 GPU 内存不足,而在于我们使用它的效率太低。
让我们了解为什么会这样,以及……176K请求完成后,分配器会将其块归还到池中。另一个请求可以立即重用这些块。PagedAttention 论文报告称,KV 缓存浪费接近于零,并且吞吐量比受测系统高出 2 倍至 4 倍。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题标记了第十节;后文只在下一段开始介绍分页所解决的问题。 原文仅说明分页的关注点,尚未给出具体分页机制或性能结果。 这是作者对简单分配方式内存利用问题的概括;具体浪费程度取决于分配器和请求分布。 这是作者对 PagedAttention 工作方式的描述;未在本段中量化其具体开销或适用限制。 仅依据给定原文保留作者归属,未对身份作额外核验。 仅依据给定原文记录账号,未对其真实性作额外核验。 保留原文符号。 原文未提供年份,因此仅译出月份和日期。 保留原文对内容类型的标注。 标题中的感叹语气属于作者原文表达,不代表独立核验结论。 这是作者的概括性判断;给定片段没有提供其适用规模、实验条件或完整后文。 原文未说明该数值的具体含义、单位或统计口径,因此不作补充解释。 “接近于零”和“高出 2 倍至 4 倍”是原文归于论文的报告,不应视为本资料已独立核验的普遍结果;受测系统范围也未在本段说明。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
分页
本节从单个请求的缓存内容转向服务系统如何在多个请求之间分配缓存内存。
本文语境解释,未作为独立知识专题收录。
多请求缓存分配
作者区分了缓存内容管理与缓存资源管理:前者关注单个请求保存哪些信息,分页关注多个并发请求如何共享服务引擎的缓存内存。
本文语境解释,未作为独立知识专题收录。
连续内存分配的浪费
本段说明按请求预留连续且接近最大长度的内存时,会因请求实际较短或请求陆续结束而产生未使用空间和内存间隙。
本文语境解释,未作为独立知识专题收录。
PagedAttention 的分块机制
本段介绍分页式 KV 缓存:把内存切成固定大小的块,并允许单个请求从共享池中取得不连续的块。
本文语境解释,未作为独立知识专题收录。
作者姓名
这是文章署名中的作者姓名。
本文语境解释,未作为独立知识专题收录。
作者账号
这是署名旁显示的作者账号。
本文语境解释,未作为独立知识专题收录。
分隔符
这是署名信息中的分隔符。
本文语境解释,未作为独立知识专题收录。
发布日期
这是原文显示的日期信息。
本文语境解释,未作为独立知识专题收录。
内容类型
这是原文标示的内容类型。
本文语境解释,未作为独立知识专题收录。
文章标题
这是文章标题,指出文章主题是以易懂方式解释大语言模型中的分页注意力。
本文语境解释,未作为独立知识专题收录。
LLM 服务中的内存瓶颈
本段引出文章论点:在大规模 LLM 服务中,内存利用效率可能比计算能力更早限制系统。原文在此处以省略号截断。
本文语境解释,未作为独立知识专题收录。
互动数据
这是原文显示的数值信息,可能属于文章或平台的互动指标。
本文语境解释,未作为独立知识专题收录。
块的回收与吞吐量
本段说明请求结束后,其占用的块可以回到共享池并被其他请求使用,并引用论文报告来描述内存浪费和吞吐量结果。
本文语境解释,未作为独立知识专题收录。
本块新增 13 项
英文原文 20
266 词A fixed pool can hide the effect of quantization. The engine may reserve the same 8 GB before and after enabling FP8. Smaller entries increase the number of tokens that fit inside that pool. The allocated memory shown by nvidia-smi may remain unchanged.
The example below begins with six free blocks. Request A takes three. Request B takes two. A then finishes and returns its blocks before request C arrives.
free_blocks = [0, 1, 2, 3, 4, 5]

request_a = free_blocks[:3]
free_blocks = free_blocks[3:]

request_b = free_blocks[:2]
free_blocks = free_blocks[2:]

free_blocks.extend(request_a)
free_after_a = free_blocks.copy()
request_c = free_blocks[:2]
free_blocks = free_blocks[2:]

print("request A blocks:", request_a)
print("request B blocks:", request_b)
print("free after A finishes:", free_after_a)
print("request C blocks:", request_c)

# Output:
"""
request A blocks: [0, 1, 2]
request B blocks: [3, 4]
free after A finishes: [5, 0, 1, 2]
request C blocks: [5, 0]
"""
After A finishes, the free pool contains block 5 and A's returned blocks. Request C takes blocks 5 and 0. Those block numbers are not adjacent, but the block table records their order for C.
This is the central paging idea. The allocator reuses available blocks instead of searching for one large continuous region.
vLLM also tracks which request owns each block. Its attention code can read the non-adjacent blocks in logical sequence order. The short example isolates allocation and reuse.
Quantization still changes the capacity inside this pool. An 8 GB pool holds 26,214 tokens at 320 KB per token, compared with 52,428 tokens at 160 KB. Total allocated GPU memory remains 8 GB in both cases.
中文译文 20
403 字固定大小的池可能会掩盖量化的影响。启用 FP8 前后,引擎都可能预留同样的 8 GB。更小的条目会增加该内存池能够容纳的 token 数量。nvidia-smi 显示的已分配内存可能保持不变。
下面的示例从六个空闲块开始。请求 A 占用三个。请求 B 占用两个。随后 A 完成并归还其块,然后请求 C 到达。
free_blocks = [0, 1, 2, 3, 4, 5]

request_a = free_blocks[:3]
free_blocks = free_blocks[3:]

request_b = free_blocks[:2]
free_blocks = free_blocks[2:]

free_blocks.extend(request_a)
free_after_a = free_blocks.copy()
request_c = free_blocks[:2]
free_blocks = free_blocks[2:]

print("request A blocks:", request_a)
print("request B blocks:", request_b)
print("free after A finishes:", free_after_a)
print("request C blocks:", request_c)

# Output:
"""
request A blocks: [0, 1, 2]
request B blocks: [3, 4]
free after A finishes: [5, 0, 1, 2]
request C blocks: [5, 0]
"""A 完成后,空闲池包含块 5 以及 A 归还的块。请求 C 取得块 5 和块 0。这些块编号并不相邻,但块表会记录它们对 C 而言的顺序。
这就是分页的核心思想。分配器会重用可用的块,而不是寻找一大片连续的区域。
vLLM 还会跟踪每个块属于哪个请求。其注意力代码可以按照逻辑顺序读取不相邻的块。这个简短示例将分配与重用过程单独展示出来。
量化仍会改变该内存池内部的容量。一个 8 GB 的内存池在每个 token 占用 320 KB 时可容纳 26,214 个 token,而在每个 token 占用 160 KB 时可容纳 52,428 个 token。两种情况下,GPU 的总已分配内存都保持为 8 GB。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
作者使用“可能”限定了这些现象;实际显示和预留行为取决于具体引擎及其内存管理方式。 这是对紧接着代码示例的情境说明;未涉及真实服务系统中的并发或调度细节。 保留原文语言标记;未执行代码。 这是示范分配和回收顺序的简化代码;未执行代码,也未据此推断真实系统性能。 这是对示例状态的解释;本段没有说明块表的具体数据结构或实现成本。 这是作者对机制的概括,不等同于所有实现都完全不进行连续区域搜索。 这是作者对 vLLM 能力的描述;给定原文没有提供实现代码、版本或性能验证。 数字和结论均按原文保留;本段未说明 GB、KB 的换算口径,也未提供计算过程或外部核验。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
固定内存池与量化
本段区分了内存池的预留容量与池内可容纳的 token 数量:量化缩小单个条目后,容量可能增加,但固定池的已分配大小不一定变化。
本文语境解释,未作为独立知识专题收录。
块分配示例
本段说明代码示例的状态变化顺序:初始有六个空闲块,A 和 B 依次取得块,A 结束后释放的块可供 C 使用。
本文语境解释,未作为独立知识专题收录。
代码语言标记
这是代码单元的语言标记,表示代码使用 Python。
本文语境解释,未作为独立知识专题收录。
空闲块回收与重用代码
代码先创建六个空闲块,让请求 A 取得前三个、请求 B 取得接下来的两个;A 完成后将其块放回空闲池,再让请求 C 取得前两个空闲块,最后打印各请求的块分配和 A 完成后的空闲列表。代码中的注释输出展示了原文给出的结果。
本文语境解释,未作为独立知识专题收录。
不连续块的逻辑顺序
本段用示例说明物理位置不相邻的块仍可被同一请求使用,块表负责记录请求读取这些块时的逻辑顺序。
本文语境解释,未作为独立知识专题收录。
分页的核心思想
本段将前面的例子概括为分页分配的基本原则:优先利用分散的可用块,避免必须找到大块连续内存。
本文语境解释,未作为独立知识专题收录。
vLLM 的块归属跟踪
本段说明系统需要同时维护块的请求归属和逻辑读取顺序,以便处理物理上不相邻的 KV 块;示例只聚焦于分配和重用。
本文语境解释,未作为独立知识专题收录。
量化改变池内容量
本段用具体数字说明:在固定为 8 GB 的池中,将每个 token 的占用从 320 KB 降至 160 KB 后,可容纳的 token 数量从 26,214 增至 52,428,但池的已分配总量不变。
本文语境解释,未作为独立知识专题收录。
本块新增 8 项
英文原文 21
161 词11. Prefix reuse
Paging reuses blocks after a request finishes. Prefix caching can share blocks while several requests are still active. It applies when those requests begin with exactly the same tokens.
This happens often with system prompts and tool definitions. Without prefix caching, the engine computes and stores another KV copy for every request. The repeated prefix consumes memory and repeats the prefill work that created it.
Automatic prefix caching stores each completed prefix block under a lookup key. When another request has the same token prefix, it points to the existing KV block. New computation begins only after the requests diverge.
vLLM builds each lookup key from the current block and its preceding blocks. It also includes details such as adapter identifiers when they affect compatibility. The vLLM prefix-caching design documents this structure.
The example below uses four-token blocks. Each lookup key contains the entire prefix up to that block. This is a readable stand-in for vLLM's chained hashes.
中文译文 21
320 字11. 前缀重用
分页会在请求完成后重用块。前缀缓存则可以在多个请求仍处于活动状态时共享块。当这些请求以完全相同的 token 开始时,就可以应用这种机制。
这种情况经常出现在系统提示词和工具定义中。没有前缀缓存时,引擎会为每个请求重新计算并存储一份 KV 副本。重复的前缀会消耗内存,并重复执行生成它所需的预填充工作。
自动前缀缓存会将每个已完成的前缀块存储在一个查找键下。当另一个请求拥有相同的 token 前缀时,它会指向已有的 KV 块。只有在请求出现分歧之后,才会开始新的计算。
vLLM 会根据当前块及其之前的块构建每个查找键。当适配器标识符等细节会影响兼容性时,vLLM 也会将其纳入查找键。vLLM 的前缀缓存设计文档说明了这一结构。
下面的示例使用四个令牌为一块。每个查找键都包含截至该块为止的完整前缀。这是对 vLLM 链式哈希的一种易读替代表示。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
保留原文的章节编号和主题表述。 “完全相同”是作者给出的适用条件;本段没有讨论部分匹配或缓存失效策略。 这是作者对无前缀缓存情形的描述;实际成本取决于前缀长度、请求数量和具体引擎。 这是机制层面的说明;本段未说明缓存淘汰、并发修改或共享块的生命周期管理。 作者将该结构归于 vLLM 的设计文档;给定资料未提供文档内容或独立核验结果。 这是作者对示例模型的说明;它明确表示该表示法只是易读的替代方案。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
前缀重用
这是文章的第 11 节标题,主题从一般的块回收转向多个活动请求之间共享相同前缀。
本文语境解释,未作为独立知识专题收录。
活动请求间共享前缀
本段区分了两种重用情形:分页通常在请求结束后回收块,而前缀缓存可让仍在处理中的多个请求共享完全相同的起始 token 对应的块。
本文语境解释,未作为独立知识专题收录。
重复前缀的成本
本段指出,共同的系统提示词或工具定义会在请求间重复出现;不共享时,不仅会产生多份 KV 数据,还会重复进行预填充计算。
本文语境解释,未作为独立知识专题收录。
自动前缀缓存流程
本段描述自动前缀缓存的逻辑:为已完成的前缀块建立查找键,后续拥有相同前缀的请求复用已有 KV,直到各请求的 token 序列不同才继续计算。
本文语境解释,未作为独立知识专题收录。
前缀缓存查找键
本段说明查找键不仅依赖当前块,还依赖前序块,并可纳入影响兼容性的适配器标识符,从而区分可安全复用的前缀缓存。
本文语境解释,未作为独立知识专题收录。
前缀查找键
本段说明示例如何用完整的令牌前缀构造查找键,并将其作为 vLLM 链式哈希的简化表示。
本文语境解释,未作为独立知识专题收录。
本块新增 6 项
英文原文 22
258 词def prefix_keys(tokens, block_size):
block_ends = range(block_size, len(tokens) + 1, block_size)
return [tuple(tokens[:end]) for end in block_ends]
first = [10, 11, 12, 13, 20, 21, 22, 23, 30, 31, 32, 33]
second = [10, 11, 12, 13, 20, 21, 22, 23, 40, 41, 42, 43]
cache = set()
first_keys = prefix_keys(first, block_size=4)
first_hits = sum(key in cache for key in first_keys)
cache.update(first_keys)
second_keys = prefix_keys(second, block_size=4)
second_hits = sum(key in cache for key in second_keys)
print("first request reused:", first_hits, "of", len(first_keys), "blocks")
print("second request reused:", second_hits, "of", len(second_keys), "blocks")
print("second request computes:", len(second_keys) - second_hits, "new block")
# Output:
"""
first request reused: 0 of 3 blocks
second request reused: 2 of 3 blocks
second request computes: 1 new block
"""The first request has no cache entries to reuse. It adds keys for its first four, eight, and twelve tokens. The second request has the same first eight tokens, so its first two keys match.
The final four tokens differ. That changes the last prefix key, so the second request computes one new block.
Using the full prefix prevents a false match. Two requests cannot reuse a block merely because four tokens match somewhere in the middle. Their preceding context must match as well.
Prefix reuse depends on exact tokenized prefixes. A timestamp in the system prompt, reordered JSON keys in a tool schema, or different chat-template whitespace can break the match.
Stable prompt templates therefore improve the hit rate. The model and cache format can remain unchanged while duplicate storage drops.
中文译文 22
371 字def prefix_keys(tokens, block_size):
block_ends = range(block_size, len(tokens) + 1, block_size)
return [tuple(tokens[:end]) for end in block_ends]
first = [10, 11, 12, 13, 20, 21, 22, 23, 30, 31, 32, 33]
second = [10, 11, 12, 13, 20, 21, 22, 23, 40, 41, 42, 43]
cache = set()
first_keys = prefix_keys(first, block_size=4)
first_hits = sum(key in cache for key in first_keys)
cache.update(first_keys)
second_keys = prefix_keys(second, block_size=4)
second_hits = sum(key in cache for key in second_keys)
print("first request reused:", first_hits, "of", len(first_keys), "blocks")
print("second request reused:", second_hits, "of", len(second_keys), "blocks")
print("second request computes:", len(second_keys) - second_hits, "new block")
# Output:
"""
first request reused: 0 of 3 blocks
second request reused: 2 of 3 blocks
second request computes: 1 new block
"""第一次请求没有可复用的缓存条目。它为前四个、前八个和前十二个令牌添加键。第二次请求的前八个令牌相同,因此它的前两个键能够匹配。
最后四个令牌不同。这会改变最后一个前缀键,因此第二次请求需要计算一个新块。
使用完整前缀可以避免错误匹配。两个请求不能仅仅因为中间某处有四个令牌相同,就复用一个块。它们之前的上下文也必须匹配。
前缀复用取决于分词后完全一致的前缀。系统提示中的时间戳、工具架构中重新排序的 JSON 键,或不同的聊天模板空白字符,都可能破坏匹配。
因此,稳定的提示模板可以提高命中率。在模型和缓存格式保持不变的情况下,重复存储量也可以下降。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
仅说明代码语言,没有额外技术结论。 代码表达了作者关于精确前缀复用的示例性结论;输出和行为仅依据原文代码说明,未进行运行核验。 这是对给定示例的直接解释,结论依赖于两次请求的令牌顺序和缓存初始为空。 这是作者基于示例令牌差异作出的结论;它没有扩展到其他缓存实现细节。 作者提出的是精确前缀匹配的逻辑要求;具体系统是否以完全相同方式实现,原文未进一步核验。 这些是作者列出的可能导致不匹配的因素,并非对所有实现的穷尽性断言。 作者将稳定模板与更高命中率、较少重复存储联系起来;实际收益取决于请求模式,原文未量化。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
Python 标记
该标记表明后续代码单元使用 Python。
本文语境解释,未作为独立知识专题收录。
前缀缓存示例
代码按四个令牌为一块,生成每个完整前缀的元组作为键。第一次请求将三个键加入缓存;第二次请求复用前两个键,并因最后四个令牌不同而计算一个新块。代码末尾的注释展示了预期输出,但未在此处执行。
本文语境解释,未作为独立知识专题收录。
两次请求的命中
本段按前缀长度解释两次请求的缓存关系:第一次建立三层前缀,第二次因前八个令牌相同而命中前两层。
本文语境解释,未作为独立知识专题收录。
最后一块不匹配
最后一个四令牌块发生变化,使包含完整十二令牌前缀的最终键不同,因而不能复用。
本文语境解释,未作为独立知识专题收录。
完整前缀防止误匹配
缓存键不仅检查当前块,还检查该块之前的全部上下文,从而避免把不同上下文中的相同四令牌片段误认为可复用。
本文语境解释,未作为独立知识专题收录。
精确分词前缀
即使文本意图相近,只要分词后的令牌序列发生变化,前缀键就可能不同;原文列举了时间戳、JSON 键顺序和空白字符等变化。
本文语境解释,未作为独立知识专题收录。
稳定模板提升命中
保持提示模板稳定,有助于生成相同的分词前缀,从而增加缓存命中并减少重复保存的数据。
本文语境解释,未作为独立知识专题收录。
本块新增 7 项
英文原文 23
288 词12. Cache Offloading from GPU
Prefix reuse helps when another request begins with tokens the engine has already processed. Offloading handles a different problem. It moves KV blocks that are not currently needed from GPU memory to a larger but slower memory tier, usually CPU memory.
Those blocks may belong to a sequence paused by the scheduler or to a cached prefix retained for reuse. When the engine needs them again, it copies them back to the GPU.
There is one important limitation. A new OpenAI-compatible API request does not automatically resume the KV cache from an earlier request. Reuse happens only if the engine still tracks the sequence, recognizes an exact prefix-cache match, or restores the cache through an external storage system.
Offloading frees GPU memory without deleting the stored KV data. It does not reduce the total number of bytes held across GPU and CPU memory. The trade-off appears when the engine must transfer those blocks back before computation can continue.
The example below gives the GPU room for two sessions. Adding session C moves the oldest session, A, to CPU memory. Resuming A brings it back and moves B out.
gpu_cache = ["cache-a", "cache-b"]
cpu_cache = []

# Cache C needs GPU space, so cache A moves to CPU memory.
cpu_cache.append(gpu_cache.pop(0))
gpu_cache.append("cache-c")

print("GPU after cache C arrives:", gpu_cache)
print("CPU after cache C arrives:", cpu_cache)

# Cache A is needed again, so it returns to the GPU.
cpu_cache.remove("cache-a")
cpu_cache.append(gpu_cache.pop(0))
gpu_cache.append("cache-a")

print("GPU after cache A returns:", gpu_cache)
print("CPU after cache A returns:", cpu_cache)

# Output:
"""
GPU after cache C arrives: ['cache-b', 'cache-c']
CPU after cache C arrives: ['cache-a']
GPU after cache A returns: ['cache-c', 'cache-a']
CPU after cache A returns: ['cache-b']
"""
中文译文 23
414 字12. 从 GPU 卸载缓存
当另一个请求以引擎已经处理过的令牌开头时,前缀复用会有所帮助。卸载处理的是另一个问题:它将当前不需要的 KV 块从 GPU 内存移到容量更大但速度更慢的内存层,通常是 CPU 内存。
这些块可能属于被调度器暂停的序列,也可能属于为重复使用而保留的缓存前缀。当引擎再次需要它们时,会将它们复制回 GPU。
有一个重要限制。新的 OpenAI 兼容 API 请求不会自动从较早请求恢复 KV 缓存。只有在引擎仍在跟踪该序列、识别出精确的前缀缓存匹配,或通过外部存储系统恢复缓存时,才会发生复用。
卸载可以释放 GPU 内存,而不会删除已存储的 KV 数据。它不会减少 GPU 和 CPU 内存合计持有的字节数。当引擎必须在继续计算前把这些块传回时,代价就会体现出来。
下面的示例让 GPU 能容纳两个会话。加入会话 C 后,最旧的会话 A 被移到 CPU 内存。恢复 A 时,会将它移回 GPU,并把 B 移出。
gpu_cache = ["cache-a", "cache-b"]
cpu_cache = []

# Cache C needs GPU space, so cache A moves to CPU memory.
cpu_cache.append(gpu_cache.pop(0))
gpu_cache.append("cache-c")

print("GPU after cache C arrives:", gpu_cache)
print("CPU after cache C arrives:", cpu_cache)

# Cache A is needed again, so it returns to the GPU.
cpu_cache.remove("cache-a")
cpu_cache.append(gpu_cache.pop(0))
gpu_cache.append("cache-a")

print("GPU after cache A returns:", gpu_cache)
print("CPU after cache A returns:", cpu_cache)

# Output:
"""
GPU after cache C arrives: ['cache-b', 'cache-c']
CPU after cache C arrives: ['cache-a']
GPU after cache A returns: ['cache-c', 'cache-a']
CPU after cache A returns: ['cache-b']
"""上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题区分了前缀复用与缓存卸载这一不同问题。 原文使用“通常”描述 CPU 内存,表明这不是唯一可能的内存层。 这是作者对卸载生命周期的概括,未说明具体调度策略或传输实现。 这是作者明确提出的限制;原文没有指定某个 API 或引擎版本的更多条件。 作者明确区分了 GPU 可用容量和 GPU、CPU 合计存储量,并指出传输时间是主要权衡之一。 这是一个抽象的容量示例;原文没有说明具体淘汰策略是否适用于所有引擎。 仅说明代码语言,没有额外技术结论。 代码是对卸载流程的简化模拟,列表中的名称代替了真实 KV 张量;不能据此推断实际引擎的完整行为。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
GPU 缓存卸载
这是关于将当前不需要的 KV 块从 GPU 内存移到较大但较慢的内存层的章节标题。
本文语境解释,未作为独立知识专题收录。
卸载的作用
前缀复用关注请求之间的已有前缀,而卸载关注内存容量:把暂时不用的 KV 块移出 GPU,以释放 GPU 空间。
本文语境解释,未作为独立知识专题收录。
卸载与恢复
卸载对象可以是暂停序列的块或保留的缓存前缀;恢复计算时,相关块需要返回 GPU。
本文语境解释,未作为独立知识专题收录。
API 请求不会自动恢复
新的 API 请求与先前请求之间不会仅凭请求到达而自动共享 KV 缓存;复用需要序列跟踪、精确前缀匹配或外部存储恢复。
本文语境解释,未作为独立知识专题收录。
容量与传输的权衡
卸载改变的是数据所在位置,而不是数据总量;收益是释放 GPU 空间,代价是恢复时需要进行数据传输。
本文语境解释,未作为独立知识专题收录。
会话的缓存换入换出
示例用两个 GPU 容量位置展示先进缓存被移到 CPU,以及恢复该缓存时另一个缓存被移出的过程。
本文语境解释,未作为独立知识专题收录。
Python 标记
该标记表明后续代码单元使用 Python。
本文语境解释,未作为独立知识专题收录。
缓存换入换出代码
代码用列表模拟 GPU 和 CPU 中的缓存名称:加入缓存 C 时把 A 从 GPU 移到 CPU;恢复 A 时把 B 移出 GPU,再把 A 放回 GPU。代码末尾的注释展示了预期状态,但未在此处执行。
本文语境解释,未作为独立知识专题收录。
本块新增 8 项
英文原文 24
247 词The first move leaves caches B and C on the GPU while cache A remains available in CPU memory. When cache A is needed again, the example brings it back and moves cache B out.
The lists contain cache names instead of tensors. A real engine performs this operation on KV blocks and tracks which request or reusable prefix owns each block.
The example assumes that the engine has retained enough information to identify cache A later. Sending an unrelated API request with the same label would not restore it automatically.
vLLM can enable a 16 GB CPU offloading buffer directly:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct

vllm serve "$MODEL_ID" \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
The first option sets the CPU buffer size in GB. The second selects vLLM's native CPU backend. Like the earlier serving command, this process keeps running after startup.
Offloading trades GPU capacity for transfer time. Measure resume latency and CPU bandwidth before enabling a large offload tier.
How to use them together
Some of these methods compose because they reduce different terms. Architecture-level methods still depend on how the checkpoint was trained.
For instance, take the 40 GB GQA cache from the first example.
- CLA2 can cut the unique layers in half, producing 20 GB.
- FP8 can halve the bytes per value, producing roughly 10 GB.
- A 50 percent token budget would reduce the resident cache to roughly 5 GB.
That multiplication is useful for capacity planning, but it hides model quality and kernel support.
中文译文 24
421 字第一次移动后,缓存 B 和 C 留在 GPU 上,而缓存 A 仍可在 CPU 内存中使用。再次需要缓存 A 时,示例将它移回 GPU,并把缓存 B 移出。
这些列表包含的是缓存名称,而不是张量。真实引擎会对 KV 块执行这一操作,并跟踪每个块属于哪个请求或可复用前缀。
示例假设引擎保留了足够的信息,以便之后识别缓存 A。发送一个带有相同标签但无关的 API 请求,并不会自动恢复它。
vLLM 可以直接启用一个 16 GB 的 CPU 卸载缓冲区:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct

vllm serve "$MODEL_ID" \
  --kv-offloading-size 16 \
--kv-offloading-backend native第一个选项设置以 GB 为单位的 CPU 缓冲区大小。第二个选项选择 vLLM 的原生 CPU 后端。与前面的服务命令一样,该进程在启动后会继续运行。
卸载用传输时间换取 GPU 容量。在启用较大的卸载层之前,应先测量恢复延迟和 CPU 带宽。
如何将它们结合使用
其中一些方法可以组合使用,因为它们减少的是不同的项。架构层面的方法仍然取决于检查点的训练方式。
例如,考虑第一个例子中的 40 GB GQA 缓存。
- CLA2 可以将不重复的层数减少一半,得到 20 GB。
- FP8 可以将每个值所占的字节数减半,得到大约 10 GB。
- 50% 的 token 预算会将常驻缓存减少到大约 5 GB。
这种乘法对于容量规划很有用,但它掩盖了模型质量和内核支持问题。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是对示例列表状态的解释,不代表所有系统都按此顺序选择被移出的缓存。 作者明确说明示例进行了抽象,未声称列表操作等同于真实张量传输。 这是作者对示例前提和 API 行为限制的说明;原文没有定义标签的具体语义。 这是原文给出的配置说明;具体可用性和版本条件未在本文中核验。 仅说明代码语言,没有额外技术结论。 代码展示了作者给出的 vLLM 命令示例;命令是否适用于特定安装环境或版本,原文未核验。 这些解释针对原文中的命令;“继续运行”是作者对服务进程行为的描述,未给出运行核验。 作者提出的是实践建议;原文没有给出具体延迟、带宽阈值或测量方法。 这是作者对方法组合方式的引导,具体效果仍取决于模型和部署环境。 作者明确指出组合并非无条件成立,训练方式是重要限制。 这是示例计算,不能据此推断所有模型的实际缓存大小。 这是作者给出的示例结果,实际效果取决于具体架构和实现。 作者使用“大约”限定结果;FP8 还会引入量化误差。 这是按比例推算的示例,实际常驻缓存还受工作负载和缓存策略影响。 作者提醒容量数字不等于可直接部署的结果。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
恢复缓存 A
本段按示例的两个阶段说明缓存位置变化:先把 A 卸载,再在需要时恢复 A 并卸载 B。
本文语境解释,未作为独立知识专题收录。
名称与真实 KV 块
示例只用字符串表示缓存;实际操作对象是 KV 块,同时还需要记录其请求归属或前缀归属。
本文语境解释,未作为独立知识专题收录。
恢复需要可识别信息
能够恢复缓存 A 的前提是引擎仍保留并能识别相关状态;仅有相同标签的无关请求不足以触发恢复。
本文语境解释,未作为独立知识专题收录。
启用 CPU 卸载缓冲区
本段引出一个 vLLM 配置示例,用于设置 16 GB 的 CPU 卸载缓冲区。
本文语境解释,未作为独立知识专题收录。
Bash 标记
该标记表明后续代码单元使用 Bash 命令。
本文语境解释,未作为独立知识专题收录。
vLLM 卸载配置
代码设置模型标识,并启动 vLLM 服务:配置 16 GB 的 KV 卸载大小,并选择 native CPU 卸载后端。代码本身未在此处执行。
本文语境解释,未作为独立知识专题收录。
两个卸载参数
本段解释两个命令行选项分别控制 CPU 缓冲区大小和卸载后端,并说明服务进程启动后不会立即结束。
本文语境解释,未作为独立知识专题收录。
测量卸载代价
扩大卸载空间可以缓解 GPU 容量压力,但恢复时的数据传输可能增加延迟,因此应先测量相关性能指标。
本文语境解释,未作为独立知识专题收录。
组合使用
本节讨论不同 KV Cache 优化方法如何组合,以及组合时需要注意的条件。
本文语境解释,未作为独立知识专题收录。
方法组合的条件
不同方法如果作用于不同的缓存构成因素,就可能叠加节省空间;但架构相关方法受模型检查点训练方式影响。
本文语境解释,未作为独立知识专题收录。
40 GB GQA 缓存示例
作者用一个 40 GB 的 GQA 缓存说明多种优化手段逐步叠加后的容量变化。
本文语境解释,未作为独立知识专题收录。
CLA2 减少层数
在该示例中,CLA2 通过减少不重复的层,将缓存容量从 40 GB 降至 20 GB。
本文语境解释,未作为独立知识专题收录。
FP8 减少字节数
在已经降至 20 GB 的基础上,FP8 将每个值的存储字节数减半,使容量约为 10 GB。
本文语境解释,未作为独立知识专题收录。
减少 Token 预算
在前述示例中,将 token 预算设为原来的 50%,会进一步把常驻缓存从约 10 GB 降至约 5 GB。
本文语境解释,未作为独立知识专题收录。
容量估算的局限
按比例相乘可以快速估算容量节省,但不能反映优化对模型质量的影响,也不能确认底层内核是否支持。
本文语境解释,未作为独立知识专题收录。
本块新增 15 项
英文原文 25
233 词- CLA requires training.
- FP8 introduces quantization error.
- Eviction discards context.
- And the serving engine must also support the resulting layout.
These are some situations you may face, along with solutions:
- When choosing a model → Inspect KV head count, local and global layer ratios, latent-attention dimensions, and recurrent layers. These determine the starting cache before deployment.
- When serving an existing model → Test FP8 first, then standardize prefixes. Both preserve the token set. Add eviction only after workload-specific quality tests.
- When memory appears unchanged → Inspect cache capacity and block counts. A fixed pool can absorb the savings while total allocated GPU memory stays flat.
- When latency is the problem → Measure cache reads and attention time. Quest-style sparse reads may help even when they don't free capacity.
- When inactive sessions occupy the GPU → Test offloading and scheduling. Moving cold blocks can matter more than compressing the active ones further.
KV cache reduction is easier to reason about once each technique has a specific target.
This table summarizes all of the techniques we cover, what they alter, the takeaway from it, and what part they don't handle:
Start with the constraint you need to change, then pick the technique that handles it.
👉 Over to you: how do you reduce KV cache in production?
That's a wrap!
If you enjoyed this tutorial:
Find me → @_avichawla
Every day, I share tutorials and insights on DS, ML, LLMs, and RAG.
中文译文 25
437 字- CLA 需要训练。
- FP8 会引入量化误差。
- 驱逐会丢弃上下文。
- 而且,服务引擎还必须支持由此产生的布局。
以下是你可能遇到的一些情况,以及相应的解决方案:
- 选择模型时 → 检查 KV 头数量、本地层与全局层的比例、潜在注意力维度以及循环层。这些因素决定部署前的初始缓存。
- 部署现有模型时 → 先测试 FP8,然后统一前缀。两者都会保留 token 集合。只有在完成针对具体工作负载的质量测试后,才添加驱逐。
- 内存看起来没有变化时 → 检查缓存容量和块数量。固定内存池可能吸收节省的空间,使 GPU 总分配内存保持不变。
- 延迟出现问题时 → 测量缓存读取和注意力时间。即使不能释放容量,Quest 风格的稀疏读取也可能有所帮助。
- 非活跃会话占用 GPU 时 → 测试卸载和调度。移动冷块可能比进一步压缩活跃块更重要。
一旦每种技术都有了明确目标,KV Cache 的缩减就更容易理解。
下表总结了我们介绍的所有技术、它们改变的内容、由此得到的要点,以及它们没有处理的部分:
先确定你需要改变的约束,然后选择能够处理该约束的技术。
👉 交给你了:你在生产环境中如何减少 KV Cache?
本教程到此结束!
如果你喜欢本教程:
找到我 → @_avichawla [1]
我每天分享关于数据科学、机器学习、大型语言模型和检索增强生成的教程与见解。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者列出的限制;原文未说明所需训练的具体形式或成本。 作者确认存在误差,但未在此处量化其大小或对质量的具体影响。 这是作者指出的直接限制;实际影响取决于被驱逐的内容和工作负载。 作者将内核或引擎支持视为部署可行性的必要条件,但未指定支持范围。 这些是建议性的场景处理方式,不是对所有系统都适用的保证。 作者将这些架构指标视为初始缓存的重要决定因素,但未给出具体阈值或计算公式。 这是作者的推荐顺序;“保留 token 集合”不代表一定不会影响模型质量。 作者解释的是一种可能原因,不能据此排除其他内存分配因素。 作者使用“可能”限定效果,且未在此处给出具体测量方法或收益幅度。 这是针对特定资源占用情况的建议,实际优先级需要通过测试确认。 这是作者的总结性判断,并未声称某一种技术在所有目标下都更优。 原文这里只说明表格用途,当前输入未提供表格内容,因此不能补充其具体信息。 这是作者给出的决策原则,具体选择仍需结合模型和工作负载验证。 这是互动式提问,不包含作者对具体生产方案的事实判断。 这是结语,不提出新的技术主张。 原文未在此句说明具体互动方式。 这里只能确认原文提供了该账号和链接,不能据此核验账号归属或页面内容。 这是作者对其内容主题与发布频率的自我介绍;原文未提供更多具体内容或相关结论。
核验与延伸:KV Cache Engineering for LLM Serving, clearly explained ↗
解释
本块首次出现的知识点
CLA 的训练要求
CLA 不是只改变部署配置的方法,而是需要相应的训练支持。
本文语境解释,未作为独立知识专题收录。
FP8 的量化误差
FP8 通过较低精度表示减少存储,但这种压缩会带来量化误差。
本文语境解释,未作为独立知识专题收录。
驱逐的上下文代价
缓存驱逐通过移除部分内容来节省空间,因此可能使模型无法继续使用被移除的上下文。
本文语境解释,未作为独立知识专题收录。
服务引擎支持
即使缓存布局在理论上节省空间,实际服务引擎也必须能够处理该布局。
本文语境解释,未作为独立知识专题收录。
常见情况与方案
作者按模型选择、既有模型部署、内存、延迟和非活跃会话等问题,给出对应的排查或优化方向。
本文语境解释,未作为独立知识专题收录。
选择模型时检查架构
模型架构中的头数量、层比例、潜在注意力维度和循环层会影响部署前需要分配的 KV Cache。
本文语境解释,未作为独立知识专题收录。
部署现有模型
对于已经存在的模型,作者建议先尝试不改变 token 集合的 FP8 和前缀标准化,再通过质量测试决定是否采用会丢弃上下文的驱逐。
本文语境解释,未作为独立知识专题收录。
排查内存未下降
优化后总 GPU 内存不变,可能是固定大小的内存池仍然占用了原有空间;应检查缓存容量和块数量。
本文语境解释,未作为独立知识专题收录。
排查延迟问题
如果瓶颈是延迟,应分别测量读取缓存和执行注意力所耗的时间;稀疏读取可能减少相关开销,而不一定减少缓存容量。
本文语境解释,未作为独立知识专题收录。
处理非活跃会话
当不活跃会话占用 GPU 资源时,可以测试将冷数据块移出或重新调度;相比继续压缩活跃缓存,移动这些块可能更有效。
本文语境解释,未作为独立知识专题收录。
明确技术目标
作者认为,将每种方法对应到具体要解决的约束,有助于理解其作用和适用范围。
本文语境解释,未作为独立知识专题收录。
技术总结表
作者准备通过表格对比各项技术改变的对象、主要结论和未覆盖的问题。
本文语境解释,未作为独立知识专题收录。
按约束选择技术
作者建议从实际限制出发,而不是笼统地追求缓存缩减,再匹配能够解决该限制的方法。
本文语境解释,未作为独立知识专题收录。
生产环境中的实践
作者将讨论引向读者,询问其在生产环境中采用的 KV Cache 缩减方法。
本文语境解释,未作为独立知识专题收录。
教程结束
作者用这句话结束本次教程。
本文语境解释,未作为独立知识专题收录。
后续互动
作者在教程结束后引导读者进行后续互动。
本文语境解释,未作为独立知识专题收录。
作者账号
作者提供了自己的账号 @_avichawla,链接指向 X 平台对应页面。
本文语境解释,未作为独立知识专题收录。
每日分享主题
作者说明其日常分享内容涵盖数据科学、机器学习、大型语言模型和检索增强生成。
本文语境解释,未作为独立知识专题收录。
本块新增 18 项
来源与阅读说明
正文取自用户提交的本地文件,原始文件与原图按字节归档。原网页含 3 段视频,本保存件未取得视频文件;保留静态预览(如有),完整视频请从原文链接查看。中文译文逐单元生成并由另一次模型请求审校;未进行人工全文审校、线上来源比对或代码执行。作者与日期缺失时保留未知。
阅读补充解释本文内容与限制,不冒充独立知识专题或外部事实核验。图片保持原样,图内说明单独保存。阅读器沿用 ReadLess 公共组件及中文约 400 字分块规则。