Build your own Jev (100% local)
自己构建 Jev(100% 本地运行)
2,984 个英文词 · 11 个原文块 · 19 张保存图片
总结
文章作者介绍了一种将开源大语言模型转化为本地决策引擎的方法:当应用已预先知道所有可能答案时,不让模型生成句子或 JSON,而是对固定选项进行打分并返回概率分布。以将“同一订阅被重复扣费”的工单分流到三个团队为例,模型可以一次性比较 billing、technical support 和 account access,并由应用根据概率和阈值决定自动路由或转人工审核。
作者区分了固定答案评分与结构化输出。结构化输出保证生成合法对象,但模型仍会逐 token 生成字段名和值;固定答案评分则读取下一 token 位置上对应候选标签的 logits,只在声明的选项之间应用 softmax。文章强调,0.91 表示三项候选中的概率质量分配,不代表模型有 91% 的正确率,准确性仍需通过带标签样本评估和校准。
文章说明了如何用 SGLang 的 /v1/score 和 /tokenize 接口,在本地运行 Qwen 模型实现这一机制:用单 token 标签 A、B、C 代表语义选项,检查其分词结果,读取对应分数并映射回应用选项。示例使用 Qwen/Qwen2.5-0.5B-Instruct,返回的概率为 0.67776233、0.310878605 和 0.011359035;作者还将评分路径与同一服务器上的普通文本生成进行延迟比较。
作者指出,这篇文章复现的是 Jev 风格的推理路径,而不是完整的 Jev 系统;Jev 的训练、校准、权重、RLCD 流程和评估栈并未被复现。评分适用于输出集合有限且调用方只需要标签和概率分布的任务;当输出内容无法预先枚举时,应继续使用普通生成或结构化生成,并在候选不完整时加入 OTHER 或 ESCALATE 选项。
- 大语言模型决策评分
- SGLang
- 固定答案概率分布
- 本地推理
- 结构化输出
英文原文 01
235 词 · 2 张图
Everything you need to turn an open-source LLM into a fast, local decision engine without retraining it. It covers next-token scoring, fixed choices with probability distributions, SGLang, and a hands-on benchmark against standard text generation on the same model.
Many LLM calls do not need newly written text. The application already knows the possible answers, and it only needs the model to choose one.
Suppose a support ticket says, "I was charged twice for the same subscription."
The application needs to send it to one of three teams: billing, technical support, or account access.
A normal LLM call asks the model to write an answer. It might return a sentence, a label, or a JSON object. The application waits for that text, parses it, and extracts the selected team.
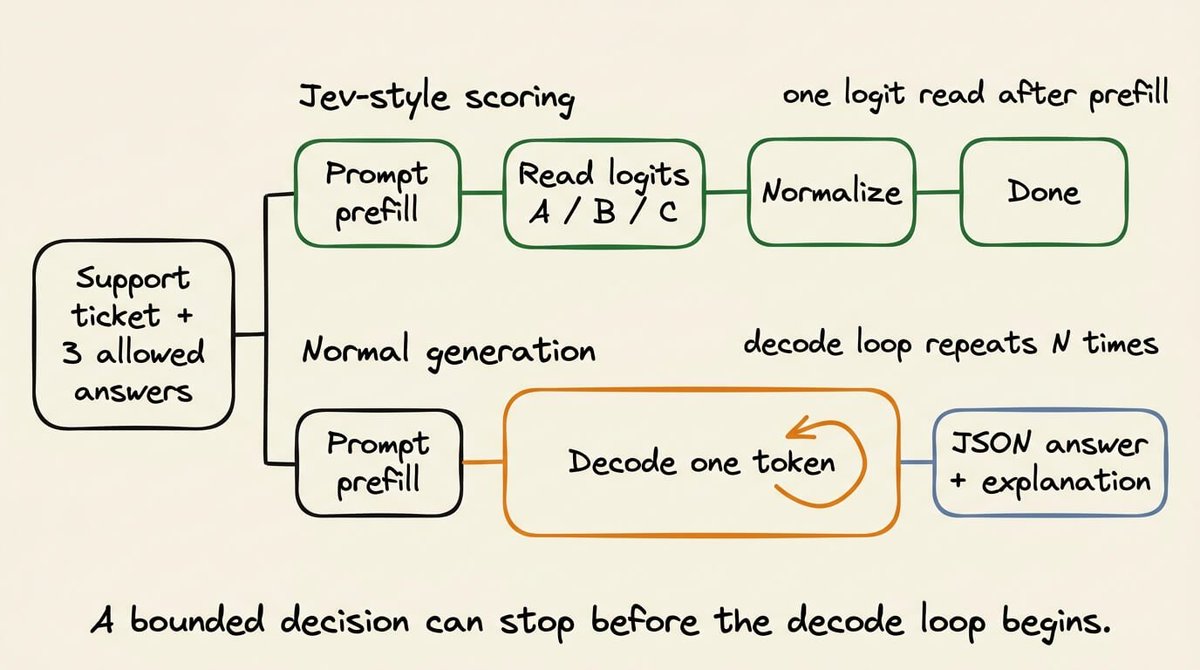
That is unnecessary if every valid answer is already known.
In fact, a better and more efficient way to do this is to treat the same request as a decision (what Jev does). The application provides the ticket/query and the three allowed answers to Jev. The model then returns a score for each answer in one go (we'll discuss shortly how exactly you can do that):
billing             0.91
technical support   0.06
account access      0.03
Billing is selected with the highest probability here, and the application code can actually see how strongly it won.
This is the behavior Jev possesses that we will reproduce locally.
中文译文 01
377 字将开源 LLM 转变为快速、本地决策引擎所需的一切,而无需重新训练它。本文涵盖下一个 token 评分、带概率分布的固定选项、SGLang,以及在同一模型上与标准文本生成进行的实践基准测试。
许多 LLM 调用并不需要新写出的文本。应用已经知道可能的答案,只需要模型选择其中一个。
假设一张支持工单写着:“同一个订阅我被收了两次费用。”
应用需要将它发送给三个团队中的一个:计费、技术支持或账户访问。
普通的 LLM 调用会要求模型写出一个答案。它可能返回一个句子、一个标签或一个 JSON 对象。应用等待这段文本,解析它,然后提取所选团队。
如果每个有效答案都已经已知,这样做就是不必要的。
事实上,更好且更高效的做法是将同一个请求视为一次决策(这正是 Jev 所做的)。应用向 Jev 提供工单/查询以及三个允许的答案。随后,模型一次性返回每个答案的分数(稍后我们会讨论具体如何实现):
billing             0.91
technical support   0.06
account access 0.03这里会选择概率最高的“计费”,应用代码实际上可以看到它胜出的程度。
这就是我们将在本地复现的 Jev 所具备的行为。
上下游
本块首次出现的来源与延伸
完整性仅针对提交文件,作者观点与事实核验分开。
本地原文已读取;线上来源未独立访问本块新增 1 项
判断
对本块内容的判断
作者将其描述为对 Jev 推理路径的本地复现,而不是完整系统;相关性能和结果需以文中的实际测试为准。 这是作者对一类 LLM 应用的概括,并非断言所有调用都适用。 这是作者构造的示例,不代表真实工单或已核验事件。 作者仅列出这三个选项;是否覆盖所有实际情况,原文未说明。 这是作者对常见流程的描述;具体返回格式取决于应用和模型配置。 这是作者的效率判断,未在此处提供量化依据。 “更好且更高效”是作者的观点;具体效率优势需要结合实现和基准测试判断。 仅为格式标签,不包含决策结果。 这些数值是原文示例,不能据此推断实际模型输出或校准质量。 作者将 0.91 视为最高概率;这些概率的准确含义和校准程度在此处尚未核验。 作者明确限定为行为或推理路径的复现,并未声称复现 Jev 的全部能力。
解释
本块首次出现的知识点
构建本地决策引擎
本文介绍如何利用开源语言模型的评分能力,在本地完成固定选项决策,并比较这种方式与普通文本生成的差异。
本文语境解释,未作为独立知识专题收录。
固定答案的调用
当任务的答案集合预先确定时,生成完整文本并非必要,模型只需在既定选项中作出选择。
本文语境解释,未作为独立知识专题收录。
支持工单示例
该工单提供了后续分类决策所需的具体输入。
本文语境解释,未作为独立知识专题收录。
三个处理团队
工单分类被定义为一个只有三个有效结果的选择问题。
本文语境解释,未作为独立知识专题收录。
普通文本生成流程
普通调用通过生成文本表达选择,应用随后还要等待、解析并提取结果。
本文语境解释,未作为独立知识专题收录。
避免多余生成
当有效答案集合固定时,生成额外句子或对象会增加不必要的处理步骤。
本文语境解释,未作为独立知识专题收录。
将请求视为决策
作者把任务从“生成答案”改成“为预先给定的答案评分”,以便一次返回所有候选结果的相对支持程度。
本文语境解释,未作为独立知识专题收录。
纯文本格式
该单元标示紧随其后的代码块采用纯文本格式。
本文语境解释,未作为独立知识专题收录。
候选答案概率
代码块展示三个团队及其对应分数或概率分布:计费最高,技术支持和账户访问较低。
本文语境解释,未作为独立知识专题收录。
依据最高概率选择
应用不仅获得最终选项,还能获得各候选项的相对概率,从而了解选择的强弱。
本文语境解释,未作为独立知识专题收录。
本地复现目标
本文的实现目标是复现 Jev 通过候选评分返回决策分布的推理行为。
本文语境解释,未作为独立知识专题收录。
本块新增 11 项
英文原文 02
219 词 · 2 张图We will provide the input query and allowed answers. In one scoring request, the model will return a decision and a probability distribution without generating a sentence or JSON object.
While Jev is closed-source, this inference pattern is already available in several open language models.
More specifically, we will implement it using SGLang (through /v1/score), test it with Qwen and DeepSeek models, and compare it against structured output and ordinary text generation.
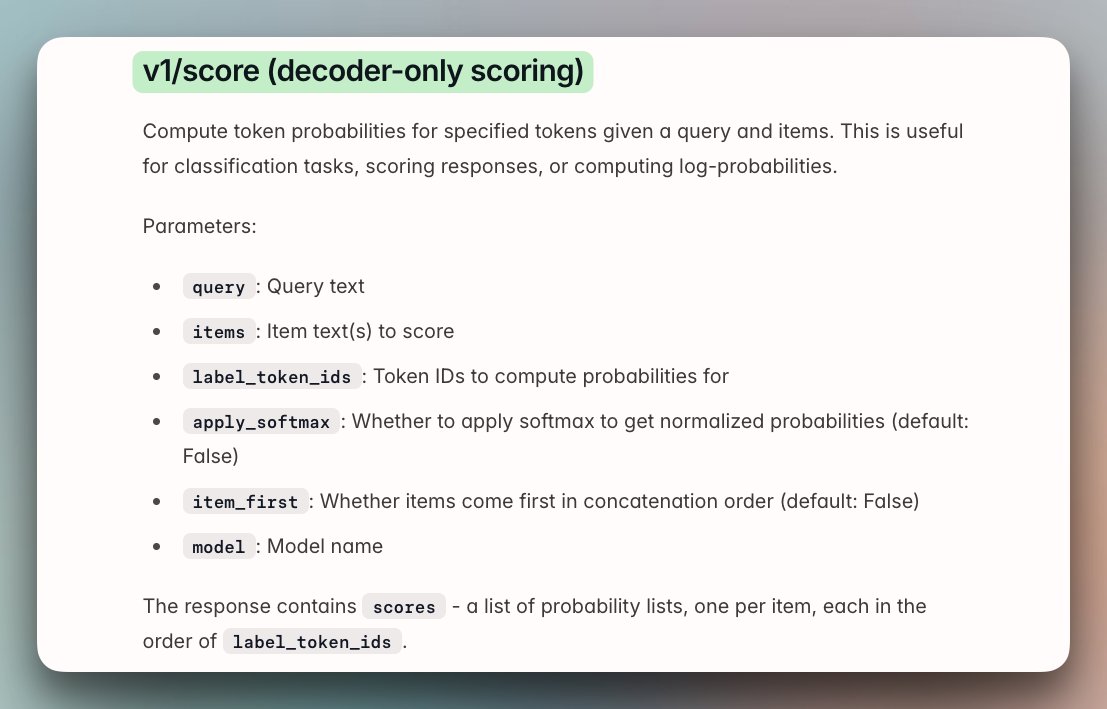
To set expectations upfront, this article recreates the inference path, not the complete Jev system. Jev also includes training and calibration work that a scoring endpoint does not provide.
Fixed-answer scoring is different from structured output
It is easy to confuse Jev's mechanism with structured output since both approaches restrict what the application receives, but they do different work inside the inference server.
For the same support ticket discussed above, a structured output might get the following output from the model:
{"team": "billing"}The specified schema prevents an invalid object, so it does not select the team on its own.
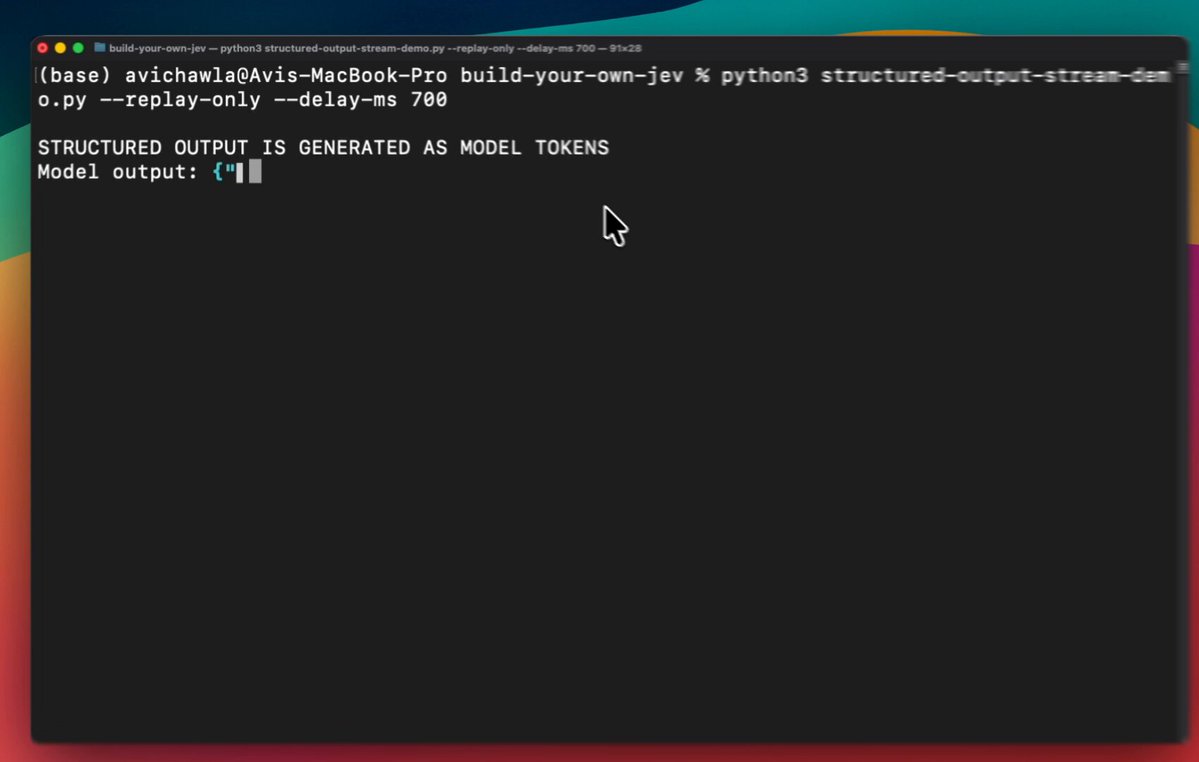
However, this can be further improved since, under the hood, the model still generates the opening brace, the field name, the value, and the closing brace one token at a time. Once generation finishes, the application reads the team field. This video depicts this process:
中文译文 02
369 字我们将提供输入查询和允许的答案。在一次评分请求中,模型会返回一个决策和一个概率分布,而不会生成句子或 JSON 对象。
虽然 Jev 是闭源的,但这种推理模式已经可以在几个开放语言模型中使用。
更具体地说,我们将通过 SGLang(使用 /v1/score)来实现它,用 Qwen 和 DeepSeek 模型进行测试,并将其与结构化输出和普通文本生成进行比较。
先说明预期:本文复现的是推理路径,而不是完整的 Jev 系统。Jev 还包括训练和校准工作,而评分端点并不提供这些功能。
固定答案评分不同于结构化输出
由于这两种方法都会限制应用接收到的内容,所以很容易将 Jev 的机制与结构化输出混淆,但它们在推理服务器内部执行的是不同的工作。
对于上文讨论的同一张支持工单,结构化输出可能从模型得到如下输出:
{"team": "billing"}指定的模式会阻止无效对象,因此它并不会自行选择团队。
然而,这还可以进一步改进,因为在底层,模型仍然会一次一个 token 地生成左花括号、字段名、值和右花括号。生成完成后,应用读取 team 字段。该视频展示了这一过程:
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者所描述的目标接口行为;具体实现效果需通过后文测试确认。 原文未列出此处所称的全部模型,也未在本单元提供验证证据。 这是文章计划采用的实验方案;实际结果和适用范围仍待后文测试。 这是作者明确声明的边界;本文不能据此证明本地实现等同于完整 Jev。 标题提出作者的核心区分,具体差异由后续单元说明。 这是作者的概念性区分;具体服务器实现可能因工具而异。 “可能”表明这是示例而非固定或已核验的模型输出。 仅为格式标签,不代表内容已通过解析或验证。 这是原文提供的结构化输出示例,不代表模型实际运行结果。 这是作者对结构化输出作用范围的判断;具体约束能力取决于所用模式和服务器。 原文提到一个视频,但当前输入未提供视频内容,因此不能进一步核验或补充其展示细节。
解释
本块首次出现的知识点
评分请求的返回结果
评分接口直接处理查询与候选答案,并返回选择及其分布,跳过句子或 JSON 的生成过程。
本文语境解释,未作为独立知识专题收录。
开放模型中的推理模式
作者指出,尽管 Jev 本身不可直接查看源代码,类似的候选评分推理方式已存在于若干开放语言模型中。
本文语境解释,未作为独立知识专题收录。
实现与比较方案
作者确定了实现接口、测试模型以及两类对照方案:结构化输出和普通文本生成。
本文语境解释,未作为独立知识专题收录。
复现范围限制
评分端点只能覆盖推理阶段,不能替代 Jev 所包含的训练与校准部分。
本文语境解释,未作为独立知识专题收录。
评分与结构化输出
本节区分两种都能限制应用接收内容的机制,重点在于它们在推理服务器内部执行的工作不同。
本文语境解释,未作为独立知识专题收录。
两种机制的区别
表面上两者都能约束结果格式,但评分直接比较候选结果,而结构化输出仍围绕受约束的文本生成展开。
本文语境解释,未作为独立知识专题收录。
结构化输出示例
作者用同一分类任务展示结构化输出可能返回的 JSON 结果,以便与后面的评分方式比较。
本文语境解释,未作为独立知识专题收录。
JSON 格式
该单元标示紧随其后的代码块采用 JSON 格式。
本文语境解释,未作为独立知识专题收录。
结构化团队结果
代码块展示一个包含 team 字段的 JSON 对象,其值为 billing(计费)。
本文语境解释,未作为独立知识专题收录。
模式约束不等于决策
结构化模式负责保证对象符合规定格式,但有效的对象内容仍需要模型生成并作出选择。
本文语境解释,未作为独立知识专题收录。
结构化生成的底层过程
即使最终结果符合 JSON 模式,模型仍需逐 token 生成对象各部分,应用再从完成的对象中读取字段。
本文语境解释,未作为独立知识专题收录。
本块新增 11 项
英文原文 03
246 词 · 2 张图With scoring (which Jev does), the application can supply the three teams as the complete list of valid outcomes. The server can read one model score for each outcome and return the distribution shown earlier in this article. It does not generate a JSON object.
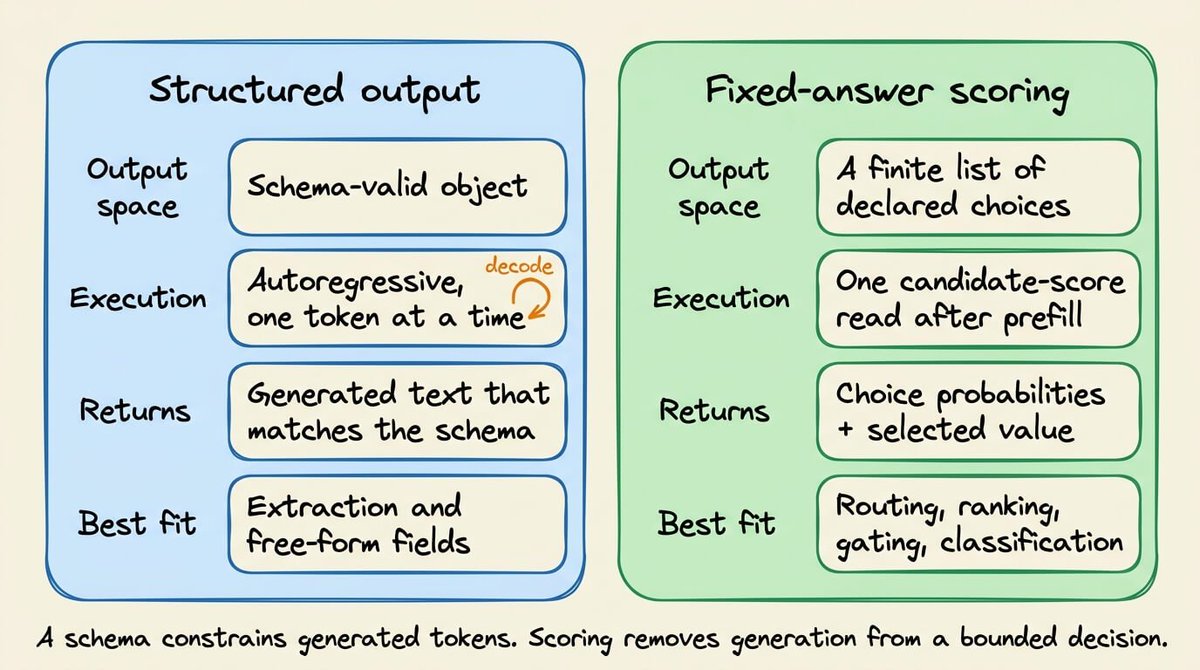
We can then return all three values instead of billing so that the application code can treat these two results differently:
Result 1                          Result 2
billing       0.91                billing       0.46
technical     0.06                technical     0.44
account       0.03                account       0.10
For instance, in the above situation, both will select billing.
But the first has a clear preference, while the second one is almost tied. The application can route the first ticket automatically and send the second one for review if needed.
Also, the model will only supply these scores, and the application code will set the rule for its downstream use.
For example, one might require the top answer to exceed 0.80 and lead the second answer by at least 0.20. Those thresholds live in code, where they can be tested and changed.
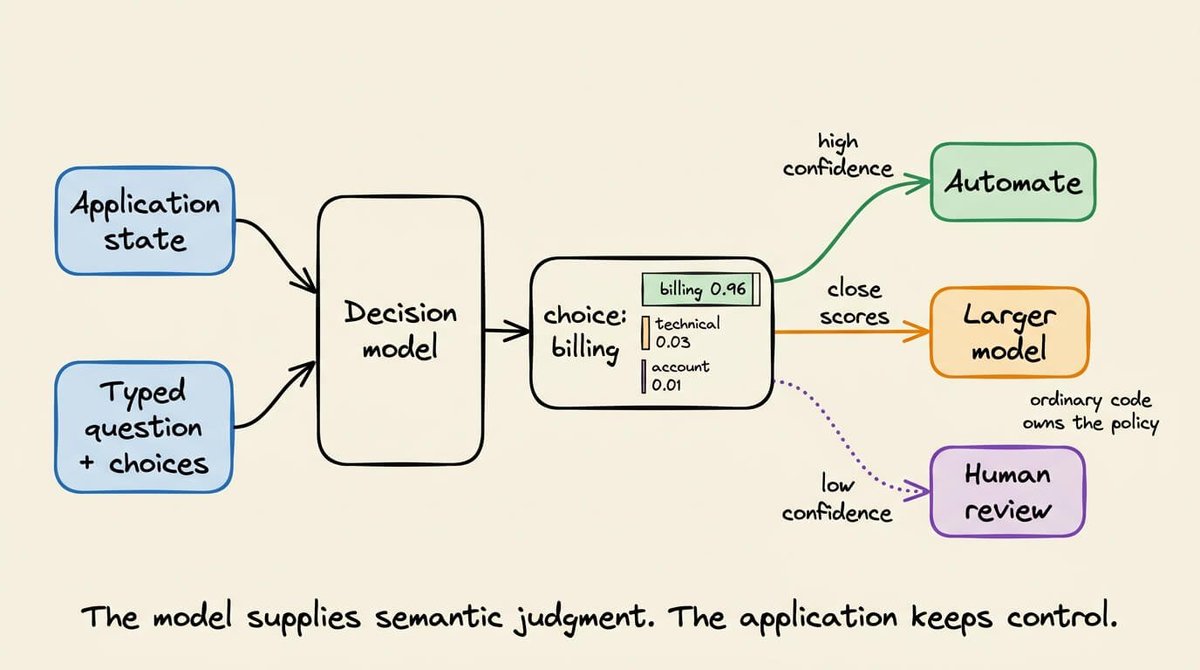
A value of 0.91 means billing received 91 percent of the probability mass to these three choices. It does not prove that the model is correct 91 percent of the time. We need labeled examples to measure that. This is the calibration problem I will discuss later.
But in the meantime, remember that structured output generates a valid object. Fixed-answer scoring returns a distribution over answers the application already knows.
中文译文 03
403 字使用评分(Jev 所采用的方式)时,应用可以将三个团队作为完整的有效结果列表提供给服务器。服务器可以读取模型对每个结果的一个分数,并返回本文前面展示的分布。它不会生成 JSON 对象。
然后我们可以返回全部三个值,而不是只返回 billing,这样应用代码就能区别处理以下两种结果:
Result 1                          Result 2
billing       0.91                billing       0.46
technical     0.06                technical     0.44
account 0.03 account 0.10例如,在上述情况下,两者都会选择 billing。
但第一个结果有明确的偏好,而第二个结果几乎难分高下。应用程序可以自动路由第一个工单,并在需要时将第二个工单发送审核。
此外,模型只会提供这些评分,应用程序代码将设定它们在下游使用时所遵循的规则。
例如,可以要求最高答案超过 0.80,并且至少领先第二个答案 0.20。这些阈值位于代码中,因此可以进行测试和修改。
数值 0.91 表示,在这三个选项中,billing 获得了 91% 的概率质量。这并不能证明模型有 91% 的概率判断正确。我们需要带标签的示例来测量这一点。这就是我稍后将讨论的校准问题。
但与此同时,请记住,结构化输出会生成一个有效对象。固定答案评分则会返回一个由应用程序已经知晓的答案构成的分布。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者对评分机制的描述;分数如何计算以及是否等同于概率,需结合具体接口实现确认。 原文在此处引出后续比较;当前单元未给出“以下两种结果”的具体内容。 原文没有提供更多语境,无法确定该标记的具体用途。 这些数值被称为结果评分或概率分布,但原文尚未说明其是否经过校准。 该结论仅适用于所示的两个结果和三个类别。 是否审核以及具体路由规则由应用程序决定;原文没有断言这种策略一定正确。 原文将规则控制权归于应用程序,但未说明具体实现或规则内容。 0.80 和 0.20 只是示例阈值,原文没有证明它们适用于所有场景。 原文明确区分概率质量与正确率;在没有带标签示例之前,不能据此得出 91% 的准确率。 “有效对象”与“应用程序已经知晓”是原文的表述;未说明对象验证的具体标准。
解释
本块首次出现的知识点
直接为候选结果评分
评分方式把候选团队直接交给服务器,让服务器分别取得模型分数并返回分布,而不是生成一个包装这些信息的 JSON 对象。
本文语境解释,未作为独立知识专题收录。
返回完整分布
返回所有候选值及其分数,可以让应用区分完整候选分布与仅有单一最终选择的结果。
本文语境解释,未作为独立知识专题收录。
纯文本标记
该单元仅包含“plaintext”这一文本标记。
本文语境解释,未作为独立知识专题收录。
两个结果的概率分布
代码块展示了两个结果对 billing、technical 和 account 三个类别的评分分布。
本文语境解释,未作为独立知识专题收录。
两者选择同一类别
尽管两个结果的评分分布不同,但最高分在两种情况下都是 billing。
本文语境解释,未作为独立知识专题收录。
按置信程度路由工单
评分差距可以帮助应用程序区分明确的分类和接近并列的分类,从而决定自动处理还是人工审核。
本文语境解释,未作为独立知识专题收录。
评分与应用规则分离
模型负责输出评分,具体如何使用评分则由应用程序代码负责。
本文语境解释,未作为独立知识专题收录。
设置可调整的阈值
示例规则同时要求最高评分达到最低值,并与第二高评分保持足够差距;把阈值写入代码便于测试和调整。
本文语境解释,未作为独立知识专题收录。
评分不等于正确率
0.91 表示模型在三个候选选项之间分配给 billing 的概率质量,而不是模型长期预测正确的比例。评估这种对应关系需要带标签的示例,这涉及校准。
本文语境解释,未作为独立知识专题收录。
结构化输出与固定答案评分
原文区分两种结果:结构化输出关注生成符合结构的对象,固定答案评分则在预先定义的答案集合上给出分布。
本文语境解释,未作为独立知识专题收录。
本块新增 10 项
英文原文 04
284 词 · 2 张图How an LLM generates the first output token
Before we discuss how a causal LLM can be turned into a Jev-style model, it would be better to first understand a regular generation step in LLMs.
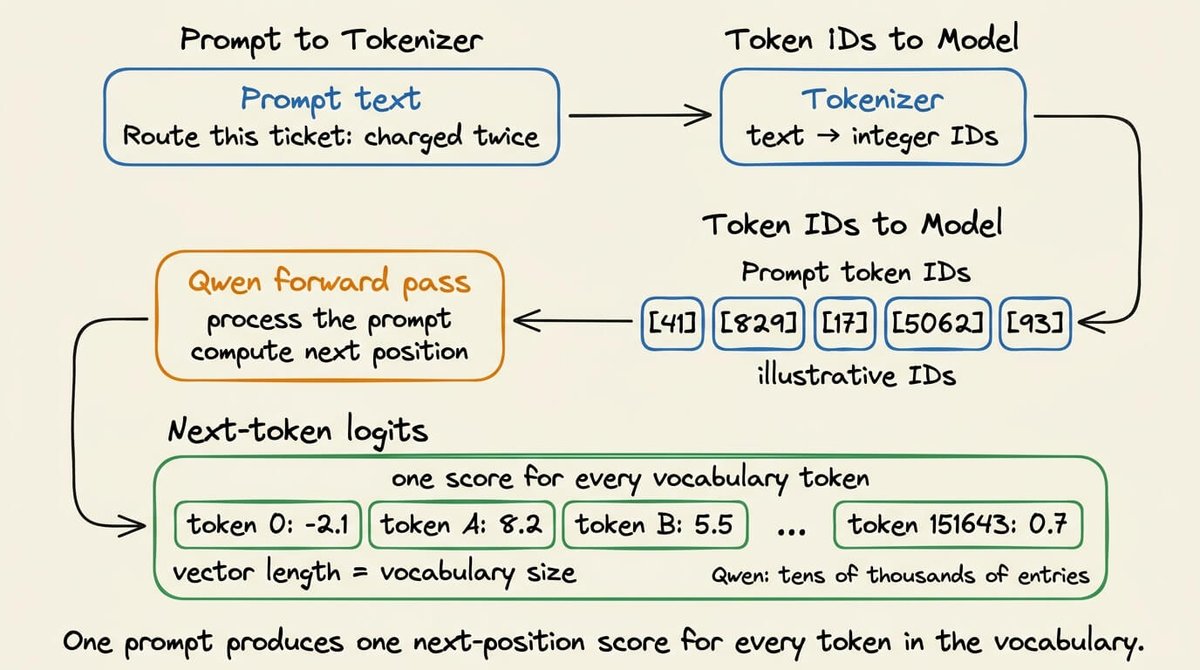
- A tokenizer first converts the prompt into token IDs.
- The model processes that sequence and produces a vector for the next position.
- The vector has one number for every token in the model's vocabulary. For instance, Qwen's vocabulary contains tens of thousands of tokens, so the vector contains tens of thousands of numbers.
Those raw numbers are logits. A larger logit means the model prefers that token as the next continuation. The values are not probabilities yet.
During normal generation, the server applies the model's decoding rules (temperature, etc.) to this vector, selects one token, and appends it to the prompt.
The model then produces a new vocabulary-sized vector for the next position. Generation/decoding repeats this process until it reaches a stop token or the output limit.
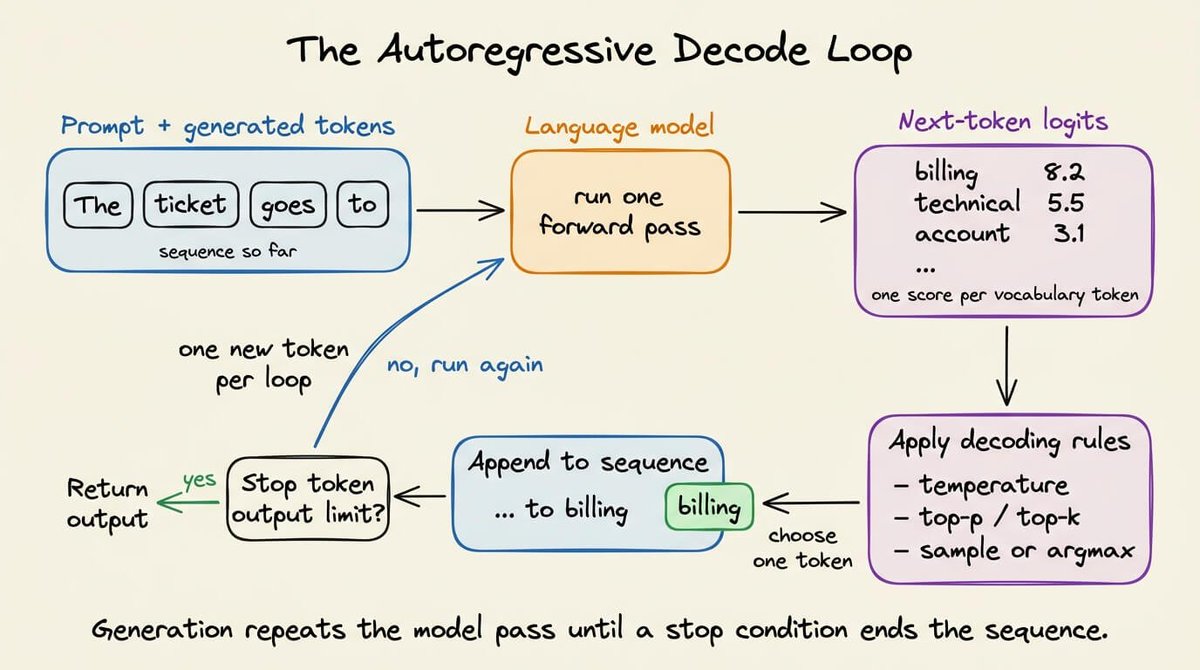
But when we want to make a bounded decision, we care about the first vector only.
Recall the support router example discussed above. The application accepts three answers:
billing
technical support
account access
In the prompt, we can assign a short label to each answer:
A = billing
B = technical support
C = account access
The prompt ends by asking for one label.
Route the support ticket into exactly one category.

Ticket:
I was charged twice for the same subscription.

Allowed labels:
A = billing
B = technical support
C = account access

Return only the label.

Label:
"Label:" is the final text in the prompt.
So the next position is therefore where the model would normally generate either A, B, or C.
中文译文 04
443 字LLM 如何生成第一个输出词元
在讨论如何将因果 LLM 转变为 Jev 风格模型之前,最好先理解 LLM 中一个常规的生成步骤。
- 分词器首先将提示转换为词元 ID。
- 模型处理该序列,并为下一个位置生成一个向量。
- 该向量中的每个数字对应模型词汇表中的一个词元。例如,Qwen 的词汇表包含数万个词元,因此该向量包含数万个数字。
这些原始数字称为 logits。logit 越大,表示模型越偏好将该词元作为下一个延续。此时这些数值还不是概率。
在正常生成过程中,服务器会将模型的解码规则(温度等)应用于这个向量,选择一个词元,并将其追加到提示中。
随后,模型会为下一个位置生成一个新的、大小等于词汇表的向量。这个生成与解码过程会反复进行,直到遇到停止词元或达到输出限制。
但当我们想要做出有界决策时,我们只关心第一个向量。
回想一下上文讨论的支持路由器示例。应用程序接受三个答案:
billing
technical support
account access在提示中,我们可以为每个答案分配一个简短标签:
A = billing
B = technical support
C = account access提示以要求输出一个标签结束。
Route the support ticket into exactly one category.

Ticket:
I was charged twice for the same subscription.

Allowed labels:
A = billing
B = technical support
C = account access

Return only the label.

Label:“Label:”是提示中的最终文本。
因此,下一个位置就是模型通常会生成 A、B 或 C 之一的位置。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题只说明讨论主题,未涉及具体模型或实现细节。 这里提出的是讲解顺序和方法,尚未给出 Jev 风格转换的具体步骤。 原文没有说明具体分词器或词元划分方式。 原文没有说明该向量的具体维度或内部计算过程。 原文仅以 Qwen 为例并使用“数万个”这一概略说法,未给出具体词汇表规模。 偏好是相对评分,不应直接解释为概率;原文没有说明后续具体转换方法。 原文以“等”概括解码规则,未列出完整规则或指定选择算法。 原文给出的停止条件是停止词元或输出限制,未说明其他可能的终止条件。 “只关心”是本文针对有界决策的处理方式,不代表所有任务都只需第一个向量。 该单元只引出列表,具体答案见后续代码块。 原文没有提供更多语境,无法确定该标记的具体用途。 这些类别属于示例中的预定义答案,原文没有说明其适用范围之外的类别。 原文只说明可以这样做,尚未说明标签选择或提示模板的具体要求。 该映射是示例中的约定;原文没有说明标签必须使用这些字母。 原文没有说明模型实际输出哪个标签,也没有说明如何处理无效或多个标签。 原文仅提供“plaintext”这一标记,未说明其进一步含义。 按给定分类,工单内容明显涉及账单;代码原文由程序逐字保留。 这是作者对提示结构的说明;它没有单独讨论模型实际输出是否一定符合要求。 原文使用“通常会”,保留了对模型行为的限定,并未断言输出必然是这三个标签之一。
解释
本块首次出现的知识点
生成第一个词元
本节标题引出对大语言模型生成过程的说明,重点是第一个输出词元。
本文语境解释,未作为独立知识专题收录。
先理解常规生成
作者先介绍普通大语言模型的生成流程,再说明如何将因果模型转换为 Jev 风格模型。
本文语境解释,未作为独立知识专题收录。
提示分词
生成流程的第一步是把输入提示拆分或映射为模型使用的词元 ID。
本文语境解释,未作为独立知识专题收录。
生成下一位置向量
模型读取词元 ID 序列后,为接下来的输出位置计算向量。
本文语境解释,未作为独立知识专题收录。
词汇表大小决定向量长度
下一位置的向量会为词汇表中的每个候选词元提供一个数值;词汇表越大,向量包含的数值通常越多。
本文语境解释,未作为独立知识专题收录。
Logits 不是概率
模型先为每个候选词元产生原始分数,较大的 logit 表示模型相对更偏好该候选,但这些分数尚未转换为概率。
本文语境解释,未作为独立知识专题收录。
解码并追加词元
服务器根据温度等解码规则处理模型输出的向量,选出一个词元,再把它加入已有提示。
本文语境解释,未作为独立知识专题收录。
重复生成直到停止
每追加一个词元,模型就为新的下一个位置计算一组词汇表大小的数值;流程持续到停止条件出现。
本文语境解释,未作为独立知识专题收录。
只关注第一个向量
对于候选范围固定的决策任务,作者认为第一次生成得到的向量就包含所需信息,因此无需继续生成完整文本。
本文语境解释,未作为独立知识专题收录。
支持路由器的候选答案
作者回到前文的支持路由器示例,并开始列出应用程序允许的三个固定答案。
本文语境解释,未作为独立知识专题收录。
纯文本标记
该单元仅包含“plaintext”这一文本标记。
本文语境解释,未作为独立知识专题收录。
三个支持类别
代码块列出了支持路由器允许的三个固定答案:账单、技术支持和账户访问。
本文语境解释,未作为独立知识专题收录。
为答案分配标签
为了让模型输出固定答案,可以在提示中用简短标签代表每个候选类别。
本文语境解释,未作为独立知识专题收录。
纯文本标记
该单元仅包含“plaintext”这一文本标记。
本文语境解释,未作为独立知识专题收录。
标签与答案的对应关系
代码块将三个固定答案分别映射到 A、B、C 三个简短标签。
本文语境解释,未作为独立知识专题收录。
要求输出单个标签
提示的最后一步是要求模型从预先定义的标签中输出一个标签,以对应某个支持类别。
本文语境解释,未作为独立知识专题收录。
纯文本标记
这是一个标示内容类型的纯文本标签。
本文语境解释,未作为独立知识专题收录。
支持工单分类提示
这段提示要求将一张关于同一订阅被重复收费的支持工单,严格归入账单、技术支持或账户访问三类之一,并且只返回对应标签。
本文语境解释,未作为独立知识专题收录。
最终提示文本
作者指出,提示以“Label:”这一字符串结束,因此模型接下来会在该位置生成内容。
本文语境解释,未作为独立知识专题收录。
标签生成位置
由于提示在“Label:”处结束,作者将紧接着的生成位置视为模型选择分类标签的位置。
本文语境解释,未作为独立知识专题收录。
本块新增 20 项
英文原文 05
285 词 · 2 张图After processing this prompt, the model will produce its usual vocabulary-sized vector for that position. That vector will contain the logit for token A, the logits for B and C, and logits for every other token in the vocabulary.
The scoring path can then perform four operations:
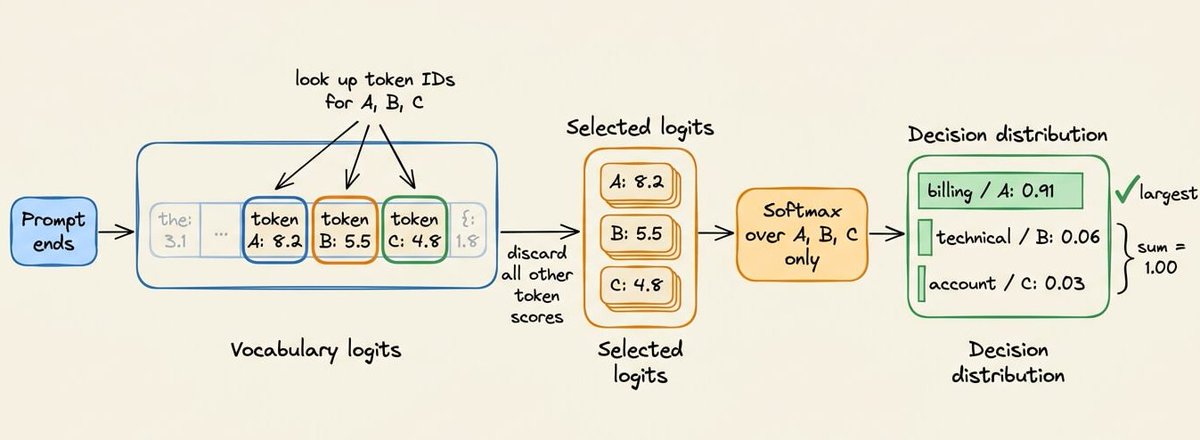
- Find the token IDs for A, B, and C.
- Read the three logits at those positions in the vocabulary vector.
- Ignore every other logit.
- Apply softmax across the three selected values.
If the selected logits are 8.2, 5.5, and 4.8, the restricted softmax produces approximately 0.91, 0.06, and 0.03. We can map those positions back to billing, technical support, and account access.
The normalization is restricted to the declared choices. We are not asking whether A has 91 percent probability across the entire vocabulary.
Instead, we are asking how the model divides its preference among A, B, and C after the application has ruled out every other response.
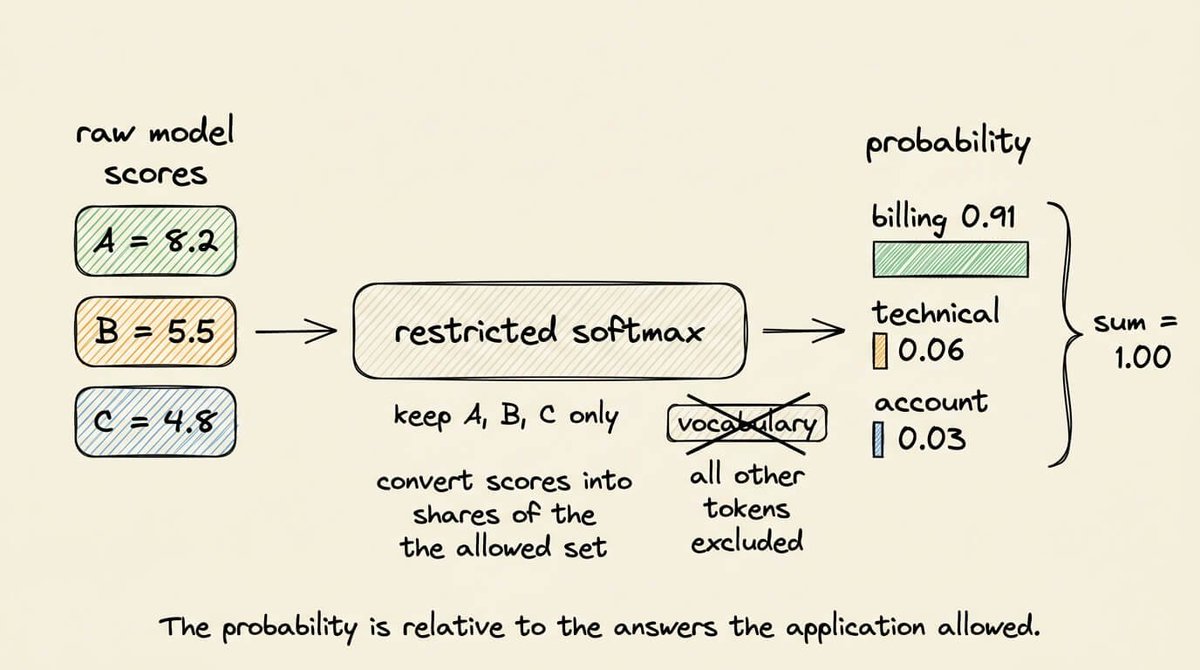
This is an operation that SGLang already implements in /v1/score.
It runs the prompt through the model, reads the requested token positions, and returns their scores. It saves us from modifying the Qwen implementation and extracting the final tensor ourselves.
Btw, the reason why the answers use A, B, and C and not score the words "billing", "technical support", and "account access" directly is because a visible word is not necessarily one token.
For instance:
- "billing" might be one token for one tokenizer and several tokens for another.
- "technical support" will definitely span multiple positions.
Comparing those phrases requires sequence scoring. The model must score the first token, append it, score the next token, and combine the values for the complete phrase. Length also becomes part of the comparison.
中文译文 05
466 字处理这个提示后,模型会为该位置生成一个与词汇表大小相同的向量。该向量会包含词元 A 的 logit、B 和 C 的 logits,以及词汇表中其他每个词元的 logits。
评分路径随后可以执行四项操作:
- 找到 A、B 和 C 的词元 ID。
- 读取词汇表向量中这些位置的三个 logit。
- 忽略所有其他 logit。
- 对选出的三个值应用 softmax。
如果选出的 logits 是 8.2、5.5 和 4.8,受限 softmax 会分别产生约 0.91、0.06 和 0.03。我们可以将这些位置映射回账单、技术支持和账户访问。
归一化仅限于声明的选项。我们并不是在询问 A 在整个词汇表中是否有 91% 的概率。
相反,我们是在询问:在应用程序排除了所有其他响应之后,模型如何在 A、B 和 C 之间分配其偏好。
这是 SGLang 已经在 /v1/score 中实现的一项操作。
它会将提示送入模型,读取请求的词元位置,并返回它们的分数。这样就不必修改 Qwen 的实现,也不必自行提取最终张量。
顺便说,答案使用 A、B 和 C,而不是直接为“billing”“technical support”和“account access”这些词评分,是因为可见的单词不一定对应一个词元。
例如:
- “billing”对一种词元化器来说可能是一个词元,对另一种词元化器来说可能是多个词元。
- “technical support”在所讨论的词元化下肯定会跨越多个位置。
比较这些短语需要进行序列评分。模型必须先对第一个词元评分,将其附加上去,再对下一个词元评分,并合并完整短语的数值。长度也会成为比较的一部分。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是对模型输出分数结构的描述;原文没有给出具体模型配置或实现细节来进一步核验。 下文列出的四项操作构成作者所述的评分路径。 原文未说明使用何种词元化器或如何查找这些 ID。 这里的“三个”对应三个候选标签;原文未涉及分数的具体数值。 这是作者定义的受限评分方法,并非对完整词汇表分布的分析。 原文明确限定 softmax 只作用于三个选定值。 结果使用“约”表示近似值;映射顺序依赖前文 A、B、C 与类别的对应关系。 原文没有把受限 softmax 结果表述为完整词汇表概率。 “排除所有其他响应”描述的是应用程序设定的候选范围,不代表模型原始词汇表中不存在其他高分词元。 这是原文对 SGLang 功能的归属说明;本文未提供独立核验信息。 这是作者对该接口作用的描述;原文未说明具体接口参数、版本或返回格式。 原文只说可见单词不一定是单个词元,并未声称所有单字符标签在所有词元化器中都必然是单词元。 这是引出示例的过渡语,具体限定见后续条目。 原文使用“可能”,没有指定具体词元化器或给出实际切分结果。 这一判断依赖具体的词元化器或模型;原文未指定其名称或提供切分结果。 这是作者对序列评分流程及其长度因素的概括,未给出具体合并公式。
解释
本块首次出现的知识点
词汇表分数向量
作者说明,模型在目标生成位置会为整个词汇表计算一组 logit,其中既包括候选标签,也包括所有其他词元。
本文语境解释,未作为独立知识专题收录。
评分流程
作者将从模型输出中提取并比较候选标签分数的过程拆分为四个步骤。
本文语境解释,未作为独立知识专题收录。
查找词元 ID
第一步是确定三个候选标签在模型词汇表中对应的词元标识符。
本文语境解释,未作为独立知识专题收录。
读取候选分数
第二步是从整个词汇表向量中提取 A、B、C 三个词元各自位置的 logit。
本文语境解释,未作为独立知识专题收录。
排除其他词元
评分时只保留三个声明过的候选标签,不使用词汇表中其他词元的分数。
本文语境解释,未作为独立知识专题收录。
计算受限 softmax
最后在 A、B、C 三个选定的 logit 之间进行 softmax,以得到它们的相对归一化结果。
本文语境解释,未作为独立知识专题收录。
示例分数映射
作者用三个具体 logit 展示受限 softmax 的结果,并将三个结果按顺序对应到三种业务类别。
本文语境解释,未作为独立知识专题收录。
受限归一化范围
作者区分了候选集合内部的归一化结果与整个词汇表上的概率,说明 0.91 只表示受限比较中的比例。
本文语境解释,未作为独立知识专题收录。
候选之间的偏好
该方法关注的是三个预先允许的响应之间的相对偏好,而不是模型对所有可能输出的整体分布。
本文语境解释,未作为独立知识专题收录。
SGLang 评分接口
作者指出,前述评分操作可通过 SGLang 的“/v1/score”实现。
本文语境解释,未作为独立知识专题收录。
接口避免底层修改
作者说明,该接口负责运行提示、读取指定词元位置并返回分数,因此可以避免直接改动 Qwen 实现或手动处理最终张量。
本文语境解释,未作为独立知识专题收录。
为何使用单字符标签
作者解释,直接比较类别短语可能受到词元切分方式影响,因此采用 A、B、C 作为候选标签,而将类别语义放在提示中。
本文语境解释,未作为独立知识专题收录。
词元化示例
下文通过两个类别短语说明不同文本可能占用不同数量的词元位置。
本文语境解释,未作为独立知识专题收录。
词元数量可能不同
同一个可见单词在不同词元化器中的切分结果可能不同,因此不能假定它总是一个词元。
本文语境解释,未作为独立知识专题收录。
多位置短语
作者以所讨论的词元化情形为范围,指出该短语会占用多个位置。
本文语境解释,未作为独立知识专题收录。
序列短语评分
多词元短语不能只读取一个输出位置,而要逐词元生成并累计分数;短语长度因此会影响比较。
本文语境解释,未作为独立知识专题收录。
本块新增 16 项
英文原文 06
264 词 · 1 张图But single-token labels avoid that problem. Every option is represented by one vocabulary entry at the same output position while the semantic meaning still appears in the prompt:
A = billing questions and payment problems
B = product errors and technical failures
C = login, password, and account access problems
The model reads those descriptions when it processes the prompt. The label is only the token whose logit we inspect afterward.
We still have to verify that each label is one token.
For instance, tokenizers often encode a leading space as part of the token. The strings "A" and " A" can therefore have different token IDs.
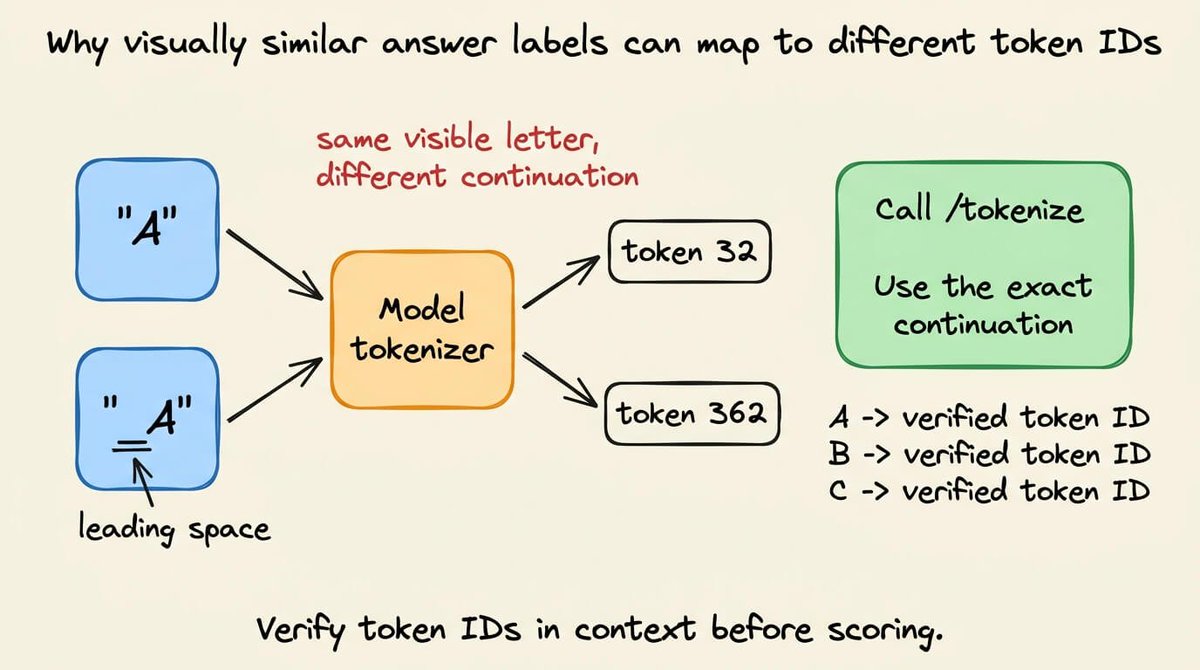
A chat template may also place whitespace or control tokens immediately before the answer position.
To avoid this, render the complete prompt using the model's chat template. Determine the exact continuation expected at the answer position. Send that continuation to /tokenize. Reject the label if it produces anything other than one token.
This label mapping stays inside the scoring client. The application sends semantic choices such as billing and technical_support. It never sends token IDs and never receives A, B, or C. That is what it means for the public API to remain independent of the model labels.
Lastly, the answer list also needs an escape route when the listed choices are not exhaustive.
For instance, if a security incident reaches a router that offers only billing, technical support, and account access, restricted softmax still assigns all probability mass to those three wrong choices.
To avoid this, add OTHER or ESCALATE when none of the named options may be correct.
中文译文 06
432 字但将每个选项设计为单个词元的标签可以避免这个问题。每个选项都在同一个输出位置由一个词汇表条目表示,同时语义仍然出现在提示中:
A = billing questions and payment problems
B = product errors and technical failures
C = login, password, and account access problems模型在处理提示时会读取这些描述。标签只是我们随后检查其 logit 的那个词元。
我们仍需验证每个标签是否是一个词元。
例如,分词器通常会把前导空格编码为词元的一部分。因此,字符串“A”和“ A”可能具有不同的词元 ID。
聊天模板也可能在答案位置之前立即放置空白或控制词元。
为避免这种情况,请使用模型的聊天模板渲染完整提示。确定答案位置所需的精确后续内容。将该后续内容发送到“/tokenize”。如果结果不是恰好一个词元,则拒绝该标签。
这种标签映射保留在评分客户端内部。应用程序发送 billing 和 technical_support 等语义选择。它从不发送词元 ID,也从不接收 A、B 或 C。这就是公共 API 保持独立于模型标签的含义。
最后,当列出的选项并不穷尽所有可能性时,答案列表还需要提供一条退出路径。
例如,如果安全事件到达一个只提供 billing、technical support 和 account access 的路由器,受限 softmax 仍会把全部概率质量分配给这三个错误选项。
为避免这种情况,当列出的选项都可能不正确时,请添加 OTHER 或 ESCALATE。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这里描述的是该方案的设计前提或目标,并不意味着 A、B、C 在所有词元化器中都必然是单个词元。 原文仅提供“plaintext”这一标记,未说明其进一步含义。 代码单元中的类别定义是后续标签评分所依据的提示内容;代码原文由程序逐字保留。 原文将语义理解归于提示描述,将数值检查归于标签词元;未进一步说明模型如何形成这种关联。 这是作者提出的实现要求;具体标签是否各自对应一个词元仍待验证。 这是关于分词器行为的说明;具体结果取决于所使用的分词器。 作者指出了可能影响标签映射的因素,但未说明具体模板会插入哪些内容。 这是作者建议的校验流程;其有效性依赖于模型聊天模板和“/tokenize”接口的实际行为。 作者主张这样可以使公共 API 不依赖模型标签;具体隔离程度取决于实现是否确实不暴露这些内部值。 这是作者提出的设计要求;哪些情况属于未覆盖范围需要由应用定义。 这是作者给出的推论性示例;实际概率分配取决于模型和评分实现。 这是作者的设计建议;是否使用以及如何处理这些选项仍需由应用决定。
解释
本块首次出现的知识点
单词元标签的设计
作者提出,将选项设计成单词元标签,可以让它们在同一位置直接比较,而类别含义由提示中的描述提供。
本文语境解释,未作为独立知识专题收录。
纯文本标记
这是一个标示内容类型的纯文本标签。
本文语境解释,未作为独立知识专题收录。
类别语义描述
这段内容将 A、B、C 分别定义为账单与付款问题、产品错误与技术故障、登录密码与账户访问问题,为单字符标签提供语义。
本文语境解释,未作为独立知识专题收录。
标签与语义的分工
作者说明,模型从提示中的类别描述理解语义,而评分阶段实际检查的是 A、B、C 标签词元的 logit。
本文语境解释,未作为独立知识专题收录。
验证词元数量
作者指出,标签必须经过词元数量检查,以确保后续评分映射成立。
本文语境解释,未作为独立知识专题收录。
前导空格影响词元
前导空格可能参与词元编码,所以表面上相近的标签可能被分配不同的词元 ID。
本文语境解释,未作为独立知识专题收录。
聊天模板的额外词元
答案前的聊天模板内容可能改变模型实际接收的上下文和词元边界。
本文语境解释,未作为独立知识专题收录。
按完整模板检查标签
流程是先用聊天模板生成完整提示,再检查答案位置的实际后续内容,并要求其编码为单个词元。
本文语境解释,未作为独立知识专题收录。
隔离模型标签
应用层使用语义化选项,评分客户端负责将它们与模型标签之间进行内部映射,从而隐藏模型专用表示。
本文语境解释,未作为独立知识专题收录。
为未列情况留出口
封闭的答案列表可能无法覆盖所有输入,因此需要允许结果脱离已列出的选项。
本文语境解释,未作为独立知识专题收录。
受限概率的错误归属
当真实类别不在候选列表中时,受限 softmax 只能在现有选项之间分配概率,因此可能强迫系统选择错误类别。
本文语境解释,未作为独立知识专题收录。
添加其他或升级选项
OTHER 或 ESCALATE 为不属于已命名类别的输入提供了可选出口。
本文语境解释,未作为独立知识专题收录。
本块新增 12 项
英文原文 07
349 词 · 1 张图Implementing a local scoring endpoint using SGLang
We only need one inference server for the local example. SGLang loads Qwen into GPU memory and exposes its native HTTP endpoints. Our Python script sends requests straight to that server.
This is the complete process:
- Start SGLang with a Qwen model.
- Write the decision as a prompt with letter labels.
- Ask SGLang to tokenize those labels.
- Send one request to /v1/score.
- Map the returned probabilities back to the choices.
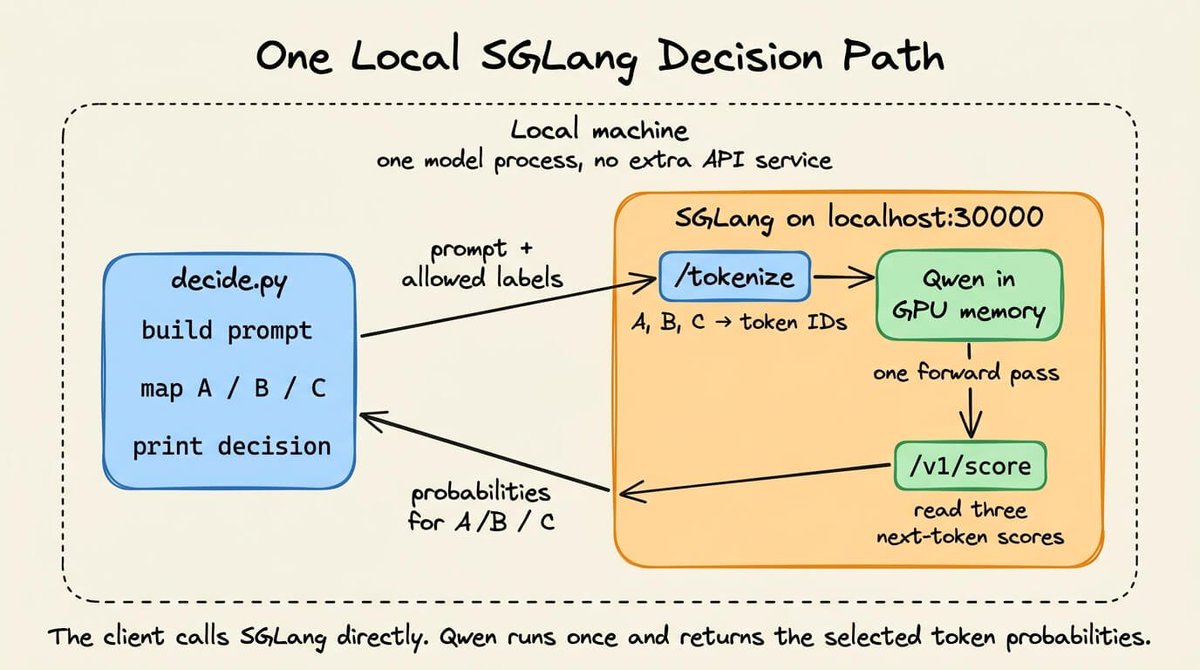
Step 1: Start Qwen with SGLang
Create a Python environment and install the two packages used here:
python3 -m venv .venv
source .venv/bin/activate
pip install "sglang[all]==0.5.10.post1" "requests==2.34.2"
Then start the model server:
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 \
  --port 30000
The first launch downloads the model from Hugging Face. Later launches reuse the local cache. Once loading finishes, Qwen remains in memory and SGLang listens on port 30000.
This SGLang process is the inference service. Keep it running while executing the client below.
Step 2: Define the choices and build the prompt
Create decide(.)py with the following code:
import json
import requests

BASE_URL = "http://127.0.0.1:30000"
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

choices = {
    "A": "billing and payments",
    "B": "technical support",
    "C": "account access",
}

ticket = "I was charged twice for the same subscription."
choice_lines = "\n".join(
    f"{label} = {meaning}" for label, meaning in choices.items()
)

prompt = f"""Ticket:
{ticket}

Question:
Which category matches the ticket?

Allowed labels:
{choice_lines}

Return only the label.
Label:
"""

print(prompt)
The dictionary records both representations of each answer.
- A is the token we score.
- And "billing" is the meaning returned to the application.
- Their order must remain unchanged through tokenization, scoring, and result mapping.
This is the exact prompt produced here:
Ticket:
I was charged twice for the same subscription.

Question:
Which category matches the ticket?

Allowed labels:
A = billing and payments
B = technical support
C = account access

Return only the label.
Label:
The prompt ends at "Label:".
We want the model's scores for the token that would appear next. We do not ask SGLang to generate that token.
中文译文 07
494 字使用 SGLang 实现本地评分端点
对于本地示例,我们只需要一个推理服务器。SGLang 将 Qwen 加载到 GPU 内存中,并暴露其原生 HTTP 端点。我们的 Python 脚本直接向该服务器发送请求。
完整流程如下:
- 使用 Qwen 模型启动 SGLang。
- 将决策写成带字母标签的提示。
- 请求 SGLang 对这些标签进行分词。
- 向“/v1/score”发送一个请求。
- 将返回的概率映射回各个选项。
步骤 1:使用 SGLang 启动 Qwen
创建 Python 环境,并安装这里使用的两个软件包:
python3 -m venv .venv
source .venv/bin/activate
pip install "sglang[all]==0.5.10.post1" "requests==2.34.2"然后启动模型服务器:
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 \
--port 30000首次启动会从 Hugging Face 下载模型。之后的启动会复用本地缓存。加载完成后,Qwen 会保留在内存中,SGLang 会监听 30000 端口。
这个 SGLang 进程就是推理服务。在执行下面的客户端时,请让它持续运行。
步骤 2:定义选项并构建提示词
创建 decide(.)py,并填入以下代码:
import json
import requests

BASE_URL = "http://127.0.0.1:30000"
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

choices = {
    "A": "billing and payments",
    "B": "technical support",
    "C": "account access",
}

ticket = "I was charged twice for the same subscription."
choice_lines = "\n".join(
    f"{label} = {meaning}" for label, meaning in choices.items()
)

prompt = f"""Ticket:
{ticket}

Question:
Which category matches the ticket?

Allowed labels:
{choice_lines}

Return only the label.
Label:
"""

print(prompt)这个字典记录了每个答案的两种表示形式。
- A 是我们评分的标记。
- 而“billing”是返回给应用程序的含义。
- 在分词、评分和结果映射过程中,它们的顺序必须保持不变。
这里生成的确切提示词如下:
Ticket:
I was charged twice for the same subscription.

Question:
Which category matches the ticket?

Allowed labels:
A = billing and payments
B = technical support
C = account access

Return only the label.
Label:提示词以“Label:”结束。
我们需要模型对下一个将出现的标记的评分。我们不要求 SGLang 生成该标记。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题表明后文将介绍该实现;未在本标题中证明其已运行或经过核验。 这是作者描述的示例架构;实际资源需求和端点行为未在原文中进一步核验。 这是作者对流程的概括;具体执行结果尚待实际运行确认。 这是流程步骤,不表示已经执行成功。 这是作者建议的提示设计;具体提示内容未给出。 这是流程步骤;具体分词结果尚待请求接口确认。 这是作者指定的接口路径;其可用性和请求格式未在原文中核验。 这是作者描述的映射步骤;具体返回格式和映射规则未给出。 这是实现流程的标题;尚不表示命令已执行或成功。 作者明确列出两个软件包,但未说明其他系统或硬件要求。 这是代码语言标记,不是执行结果。 代码中的版本和命令由原文给出;未在此处核验其可安装性或兼容性。 这是操作指引,不表示服务器已经启动。 代码中的模型路径、地址和端口由原文给出;未在此处核验模型是否可下载或服务器能否成功启动。 这些是作者对运行行为的说明;实际下载、缓存位置、内存占用和端口监听状态尚待运行确认。 这是原文对运行方式的要求;未提供服务状态的独立核验结果。 这是作者给出的流程划分。 原文只说明应创建文件并使用所列代码;未说明文件路径。 该标记表明代码使用 Python;未涉及代码执行结果。 代码中的服务地址、模型名称、类别文本和票据内容均为原文设定;代码未在此处展示请求或评分逻辑。 这是作者对该字典用途的说明;具体后续映射实现未在本单元给出。 这是作者对 A 的角色说明。 原文以 billing 作为含义示例;完整含义取决于字典映射。 这是作者提出的实现约束;原文未讨论违反该约束时的具体后果。 “确切”指原文所示的提示词内容;未提供独立运行核验。 该标记表示内容按纯文本展示。 内容是原文展示的提示词;其中标签与类别的对应关系由前文定义。 这是原文对提示词边界的明确说明。 这是作者对推理方式的描述;原文尚未给出具体评分请求代码。
解释
本块首次出现的知识点
实现本地评分端点
本节转入使用 SGLang 和本地模型服务器构建评分接口的实现步骤。
本文语境解释,未作为独立知识专题收录。
本地推理服务器
架构由一个运行 Qwen 的 SGLang 服务器和一个直接调用其 HTTP 接口的 Python 脚本组成。
本文语境解释,未作为独立知识专题收录。
完整流程
下面的列表按顺序概括启动服务器、准备标签、评分以及映射结果的步骤。
本文语境解释,未作为独立知识专题收录。
启动 SGLang
第一步是让 SGLang 加载并服务一个 Qwen 模型。
本文语境解释,未作为独立知识专题收录。
编写带标签提示
决策任务通过提示表达,并用字母表示候选答案。
本文语境解释,未作为独立知识专题收录。
对标签分词
通过分词接口检查字母标签在模型词表中的编码方式。
本文语境解释,未作为独立知识专题收录。
请求评分
评分阶段通过“/v1/score”端点提交一次请求。
本文语境解释,未作为独立知识专题收录。
还原选项概率
客户端把模型返回的概率重新对应到应用层的候选选择。
本文语境解释,未作为独立知识专题收录。
使用 SGLang 启动 Qwen
本步骤开始配置环境并启动由 SGLang 服务的 Qwen 模型。
本文语境解释,未作为独立知识专题收录。
安装依赖
在启动服务器前,先建立 Python 虚拟环境并安装指定依赖。
本文语境解释,未作为独立知识专题收录。
命令类型
该标记说明后续代码块包含 Bash 命令。
本文语境解释,未作为独立知识专题收录。
创建环境并安装软件包
代码依次创建名为“.venv”的 Python 虚拟环境、激活该环境,并安装指定版本的 SGLang 和 requests。
本文语境解释,未作为独立知识专题收录。
启动模型服务器
依赖安装完成后,下一步是运行 SGLang 的服务器启动命令。
本文语境解释,未作为独立知识专题收录。
命令类型
该标记说明后续代码块包含 Bash 命令。
本文语境解释,未作为独立知识专题收录。
启动 Qwen 服务
代码以 SGLang 启动服务器,指定 Qwen 模型路径、仅监听本机的主机地址以及 30000 端口。
本文语境解释,未作为独立知识专题收录。
模型下载与缓存
作者描述了首次启动下载模型、后续启动使用缓存,以及加载完成后持续提供本地端口服务的过程。
本文语境解释,未作为独立知识专题收录。
保持推理服务运行
作者说明客户端依赖正在运行的 SGLang 推理服务。
本文语境解释,未作为独立知识专题收录。
定义选项与提示词
本步骤将回答类别定义为选项,并据此构建发送给模型的提示词。
本文语境解释,未作为独立知识专题收录。
创建决策脚本
作者要求新建一个 Python 文件,用于定义选项、生成提示词并与推理服务交互。
本文语境解释,未作为独立知识专题收录。
Python 标记
这是后续代码块的语言标记。
本文语境解释,未作为独立知识专题收录。
构建分类提示词
代码导入 JSON 和请求库,设置本地服务地址与模型名称,定义 A、B、C 三个类别及一个账单示例。随后按选项顺序生成提示词,要求模型只返回标签,并打印该提示词。
本文语境解释,未作为独立知识专题收录。
记录答案表示
作者区分模型评分所用的标签表示与应用接收的含义表示。
本文语境解释,未作为独立知识专题收录。
评分标签
模型评分针对的是选项标签,而不是完整的类别描述。
本文语境解释,未作为独立知识专题收录。
应用含义
作者将标签对应的类别含义作为应用层返回值。
本文语境解释,未作为独立知识专题收录。
保持顺序一致
标签与含义之间的对应关系依赖顺序,因此各处理阶段都不能改变排列。
本文语境解释,未作为独立知识专题收录。
展示生成的提示词
作者接着展示前述代码实际构建出的提示词文本。
本文语境解释,未作为独立知识专题收录。
纯文本标记
这是后续文本块的格式标记。
本文语境解释,未作为独立知识专题收录。
完整提示词
该文本包含票据、分类问题、允许的 A/B/C 标签及只返回标签的要求,末尾停在 Label:。
本文语境解释,未作为独立知识专题收录。
提示词结束位置
作者指出模型接下来应在 Label: 之后给出标签。
本文语境解释,未作为独立知识专题收录。
评分下一个标记
方法目标是读取模型对下一个标记位置的分数,而不是让服务实际生成答案标记。
本文语境解释,未作为独立知识专题收录。
本块新增 30 项
英文原文 08
316 词Step 3: Resolve the label token IDs
Add this code below the prompt:
label_token_ids = []

for label in choices:
    response = requests.post(
        f"{BASE_URL}/tokenize",
        json={
            "model": MODEL,
            "prompt": label,
            "add_special_tokens": False,
        },
        timeout=30,
    )
    response.raise_for_status()
    token_ids = response.json()["tokens"]

    if len(token_ids) != 1:
        raise ValueError(
            f"{label!r} is not a single token: {token_ids}"
        )

    print(f"{label!r} -> {token_ids}")
    label_token_ids.append(token_ids[0])
SGLang's /tokenize endpoint returns the integer IDs produced by Qwen's tokenizer. We reject any label that becomes several tokens. The scoring request needs one vocabulary position for each answer.
For Qwen/Qwen2.5-0.5B-Instruct, this prints:
'A' -> [32]
'B' -> [33]
'C' -> [34]
Each list contains one integer. We therefore know that every label occupies one token. The later scoring request will read vocabulary positions 32, 33, and 34.
This check also prevents us from assuming that tokenization is identical across models. A label that works with Qwen may split under another tokenizer.
Step 4: Ask SGLang for the three probabilities
Add the scoring request next:
response = requests.post(
    f"{BASE_URL}/v1/score",
    json={
        "model": MODEL,
        "query": prompt,
        "items": [""],
        "label_token_ids": label_token_ids,
        "apply_softmax": True,
    },
    timeout=120,
)
response.raise_for_status()
score_response = response.json()

print(json.dumps(score_response, indent=2))
scores = score_response["scores"][0]- query contains the complete prompt.
- The empty "items" means we score the position immediately after it.
- "label_token_ids" tells SGLang which three entries to read from Qwen's vocabulary-sized output.
- "apply_softmax" normalizes those entries into probabilities.
The response has one score list because items contains one entry. We ran this exact prompt against the same Qwen checkpoint and obtained:
{
  "scores": [
    [
      0.67776233,
      0.310878605,
      0.011359035
    ]
  ]
}
The three positions correspond to A, B, and C. The selected logits were 25.277620, 24.498226, and 21.188837 before softmax. Small numeric differences may appear across hardware and precision settings.
The official endpoint reference states that each returned list follows the order of label_token_ids. Our first score therefore belongs to A, the second to B, and the third to C.
中文译文 08
493 字步骤 3:解析标签标记 ID
将以下代码添加到提示词代码下面:
label_token_ids = []

for label in choices:
    response = requests.post(
        f"{BASE_URL}/tokenize",
        json={
            "model": MODEL,
            "prompt": label,
            "add_special_tokens": False,
        },
        timeout=30,
    )
    response.raise_for_status()
    token_ids = response.json()["tokens"]

    if len(token_ids) != 1:
        raise ValueError(
            f"{label!r} is not a single token: {token_ids}"
        )

    print(f"{label!r} -> {token_ids}")
label_token_ids.append(token_ids[0])SGLang 的 /tokenize 端点返回 Qwen 分词器生成的整数 ID。我们拒绝任何会变成多个标记的标签。评分请求需要为每个答案提供一个词汇表位置。
对于 Qwen/Qwen2.5-0.5B-Instruct,它会打印:
'A' -> [32]
'B' -> [33]
'C' -> [34]每个列表都包含一个整数。因此,我们知道每个标签都占用一个标记。之后的评分请求将读取词汇表位置 32、33 和 34。
这项检查还避免我们假定不同模型的分词方式完全相同。对 Qwen 有效的标签,在另一个分词器下可能会被拆分。
第 4 步:让 SGLang 返回三个概率
接下来添加评分请求:
response = requests.post(
    f"{BASE_URL}/v1/score",
    json={
        "model": MODEL,
        "query": prompt,
        "items": [""],
        "label_token_ids": label_token_ids,
        "apply_softmax": True,
    },
    timeout=120,
)
response.raise_for_status()
score_response = response.json()

print(json.dumps(score_response, indent=2))
scores = score_response["scores"][0]- query 包含完整的提示词。
- 空的 "items" 表示对其紧接着的位置进行评分。
- "label_token_ids" 告诉 SGLang,要从 Qwen 词汇表大小的输出中读取哪三个条目。
- "apply_softmax" 将这些条目归一化为概率。
由于 items 包含一个条目,响应中有一个分数列表。我们将这个确切的提示词发送给同一个 Qwen 检查点后,得到:
{
  "scores": [
    [
      0.67776233,
      0.310878605,
      0.011359035
    ]
  ]
}这三个位置分别对应 A、B 和 C。在应用 softmax 之前,选定的 logits 分别为 25.277620、24.498226 和 21.188837。不同硬件和精度设置下可能会出现细微的数值差异。
官方端点参考文档说明,每个返回的列表都遵循 label_token_ids 的顺序。因此,我们的第一个分数对应 A,第二个对应 B,第三个对应 C。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者给出的流程划分;实际 ID 取决于所用模型及分词器。 原文只规定添加位置,未说明其他代码组织方式。 该标记表明代码使用 Python;未涉及代码执行结果。 代码假定服务提供 /tokenize 端点并返回 tokens 字段;若标签被分成多个标记,则抛出错误。未声称执行代码。 这是作者对 SGLang、Qwen 分词器和评分要求的描述;具体端点行为未在原文之外核验。 这些结果归属于原文作者;本资料未提供独立核验。 该标记表示内容按纯文本展示。 这些具体 ID 仅在原文指定的 Qwen 模型和分词设置下被声称成立;未在此处独立核验。 结论依赖前文所示的分词结果;原文未提供其他模型下的对应位置。 这是作者关于模型间分词差异的限制说明;原文没有给出其他模型的具体拆分示例。 这是作者对实现步骤的说明;具体结果依赖所用模型、提示词、硬件和精度设置。 这是代码前的操作说明,未提供额外的运行条件。 仅为代码语言标记。 代码展示了作者的调用方式,但不能仅凭本文确认端点、模型服务或请求一定可用;代码未在此处执行。 这是作者对请求字段的解释。 这是作者对该接口语义的说明;具体行为仍取决于接口实现。 这是作者对字段作用的解释,未进一步说明 token ID 的生成过程。 这是作者对 softmax 选项的说明。 示例结果归属于作者的运行记录;作者同时限定了使用的提示词和检查点,不能视为所有环境中的固定结果。 仅为数据格式标记。 这些数值是作者给出的示例输出,不能在未运行相同配置的情况下独立核验。 作者明确指出结果会因硬件和精度设置而产生小幅差异,因此示例数值不是绝对固定值。 该段归因于官方端点参考文档,但本文未提供文档内容或独立核验结果。
解释
本块首次出现的知识点
解析标签标记 ID
本步骤将 A、B、C 标签转换为模型分词器对应的整数标记 ID。
本文语境解释,未作为独立知识专题收录。
添加标记解析代码
作者要求在前述提示词构建代码之后加入用于获取标签标记 ID 的代码。
本文语境解释,未作为独立知识专题收录。
Python 标记
这是后续代码块的语言标记。
本文语境解释,未作为独立知识专题收录。
获取标签标记 ID
代码逐一请求本地 SGLang 的 /tokenize 端点,对每个标签关闭特殊标记添加,检查结果是否恰好包含一个标记,并把该标记 ID 按顺序保存。
本文语境解释,未作为独立知识专题收录。
检查标签分词
作者说明分词端点用于获取标签的整数 ID,并要求每个标签对应单一词汇表位置,以便后续评分。
本文语境解释,未作为独立知识专题收录。
展示标签 ID
作者给出指定模型下 A、B、C 标签的分词结果示例。
本文语境解释,未作为独立知识专题收录。
纯文本标记
这是后续输出示例的格式标记。
本文语境解释,未作为独立知识专题收录。
标签到 ID 的映射
示例显示 A、B、C 分别对应单个整数标记 32、33、34。
本文语境解释,未作为独立知识专题收录。
确定评分位置
由于每个标签的分词结果只有一个整数,后续评分可以直接针对这三个词汇表位置。
本文语境解释,未作为独立知识专题收录。
避免跨模型假设
作者强调标签是否为单一标记取决于分词器,因此需要针对实际模型检查,而不能直接复用 Qwen 的结论。
本文语境解释,未作为独立知识专题收录。
请求三个概率
本步骤使用 SGLang 的评分接口,根据模型输出中三个标签对应的分数来获得概率。
本文语境解释,未作为独立知识专题收录。
添加评分请求
作者准备通过 HTTP 请求调用评分接口,并将完整提示词和标签信息发送给模型。
本文语境解释,未作为独立知识专题收录。
Python 代码
该单元标识后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
发送评分请求
代码向 BASE_URL 下的 /v1/score 端点发送 POST 请求,提交模型名称、提示词、空的 items、标签 token ID,并要求应用 softmax。请求超时设为 120 秒;响应状态异常时抛出错误,然后解析 JSON,打印完整响应,并取出 scores 中的第一组分数。
本文语境解释,未作为独立知识专题收录。
完整提示词
评分请求使用 query 字段承载要交给模型判断的完整上下文。
本文语境解释,未作为独立知识专题收录。
评分位置
作者将空字符串作为 items 的唯一条目,以便评分该条目之后的下一个位置。
本文语境解释,未作为独立知识专题收录。
标签 token ID
该字段指定三个候选标签在 Qwen 输出中的位置,使服务能够提取对应分数。
本文语境解释,未作为独立知识专题收录。
归一化为概率
启用该选项后,选定的输出分数会经过 softmax 处理,形成可比较的概率值。
本文语境解释,未作为独立知识专题收录。
获得分数列表
响应的列表数量与 items 中的条目数量对应;作者给出了使用相同提示词和 Qwen 检查点时的示例结果。
本文语境解释,未作为独立知识专题收录。
JSON 示例
该单元标识后续内容是 JSON 格式的结果示例。
本文语境解释,未作为独立知识专题收录。
概率结果
代码块展示了一个 scores 数组,其中包含三个数值,分别对应三个候选标签的评分结果。
本文语境解释,未作为独立知识专题收录。
标签顺序与 logits
作者说明三个概率位置的标签对应关系,并区分了 softmax 前的 logits 与处理后的概率。
本文语境解释,未作为独立知识专题收录。
确认标签顺序
作者依据端点参考文档,将返回列表中的位置与传入的标签 token ID 顺序对应起来。
本文语境解释,未作为独立知识专题收录。
本块新增 23 项
英文原文 09
277 词 · 2 张图Step 5: Convert model labels back into decisions
Finish the script with the mapping code:
probabilities = {
    choices[label]: float(score)
    for label, score in zip(choices, scores, strict=True)
}

decision = max(probabilities, key=probabilities.get)

print(
    json.dumps(
        {
            "decision": decision,
            "probabilities": probabilities,
        },
        indent=2,
    )
)
Now run the script in a second terminal:
// Output after running python decide.py

{
  "decision": "billing and payments",
  "probabilities": {
    "billing and payments": 0.6777623295783997,
    "technical support": 0.31087860465049744,
    "account access": 0.011359035037457943
  }
}
SGLang performs that calculation behind /v1/score. One SGLang process tokenizes the labels, runs Qwen once, and returns the selected probabilities.
In this case, billing wins, but only with 0.678 probability. A policy requiring 0.70 would send this ticket for review instead of automating the route. That threshold should come from evaluation on labeled examples.
Measuring scoring latency against autoregressive generation
The single-request example above shows the mechanism. I also built a small application to test how that mechanism behaves across many decisions.
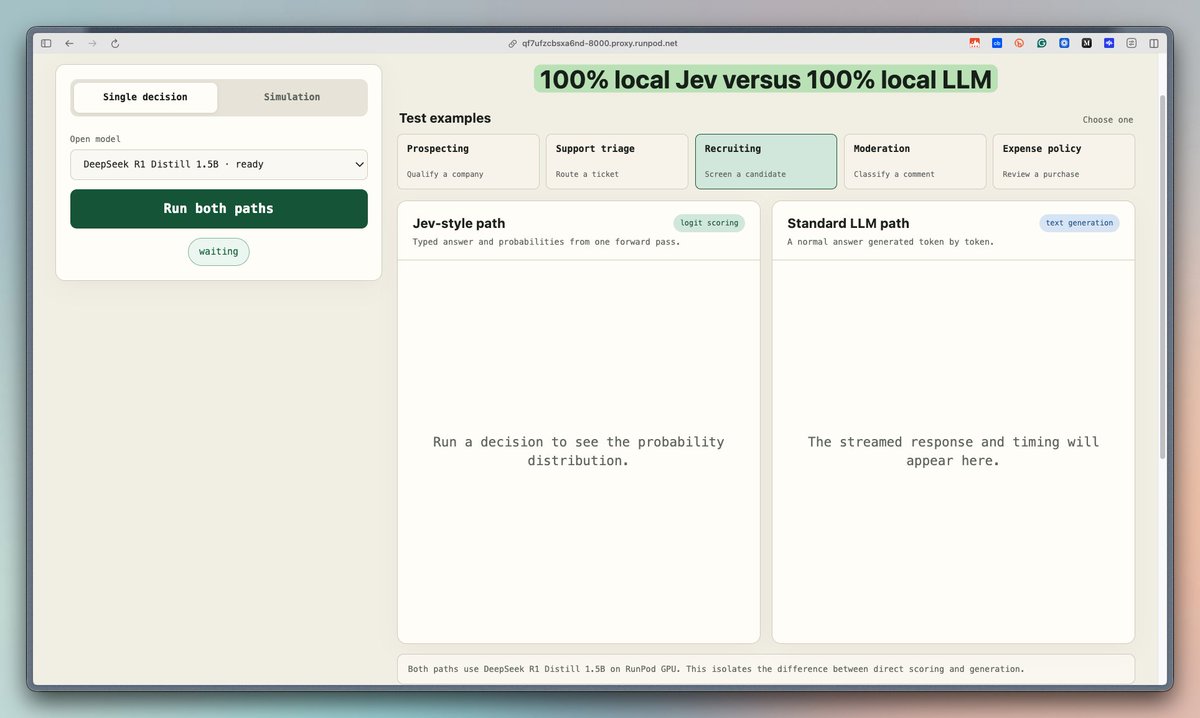
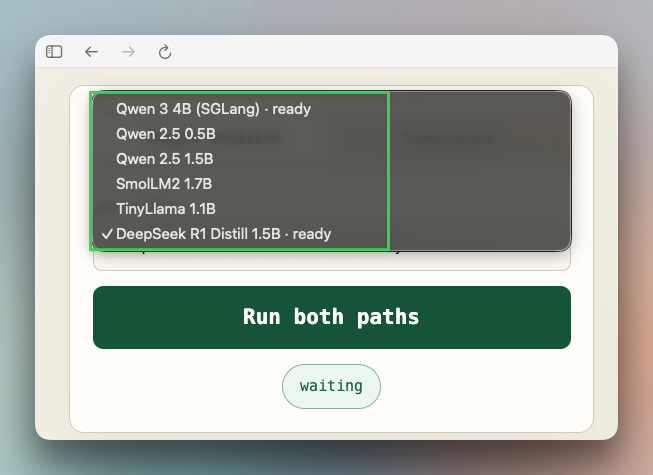
The deployed demo supports several open models, like Qwen 3 4B, Qwen 2.5 0.5B and 1.5B, SmolLM2 1.7B, TinyLlama 1.1B, and DeepSeek-R1-Distill-Qwen 1.5B.
The Jev-style lane calls the decision method:
result = engine.decide(request)

answer = result["answers"]["decision"]

choice = answer["choice"]

probabilities = answer["probabilities"]
Inside the decide() method, SGLang receives the prompt through /v1/score. The request includes the token IDs for A, B, and C.
SGLang runs the prompt, reads those three next-token scores, normalizes them, and stops. The response contains no generated tokens.
The standard lane calls the generation method on that same engine:
result = engine.generate_response(
    case["state"],
    case["question"],
    list(case["criteria"].items()),
    max_tokens=32,
)
This method sends the same state, question, and choices to /v1/chat/completions.
中文译文 09
420 字第 5 步:将模型标签转换回决策
用映射代码完成脚本:
probabilities = {
    choices[label]: float(score)
    for label, score in zip(choices, scores, strict=True)
}

decision = max(probabilities, key=probabilities.get)

print(
    json.dumps(
        {
            "decision": decision,
            "probabilities": probabilities,
        },
        indent=2,
    )
)
现在在第二个终端中运行脚本:
// Output after running python decide.py

{
  "decision": "billing and payments",
  "probabilities": {
    "billing and payments": 0.6777623295783997,
    "technical support": 0.31087860465049744,
    "account access": 0.011359035037457943
  }
}SGLang 会在 /v1/score 后台完成这项计算。一个 SGLang 进程会对这些标签进行分词,运行 Qwen 一次,然后返回选定的概率。
在这个例子中,billing 获胜,但概率只有 0.678。如果策略要求达到 0.70,就会将该工单送去审核,而不是自动路由。这个阈值应当根据带标签示例上的评估结果确定。
将评分延迟与自回归生成进行比较
上面的单请求示例展示了工作机制。我还构建了一个小型应用,用于测试该机制在许多决策中的表现。
部署的演示支持多个开放模型,例如 Qwen 3 4B、Qwen 2.5 0.5B 和 1.5B、SmolLM2 1.7B、TinyLlama 1.1B,以及 DeepSeek-R1-Distill-Qwen 1.5B。
Jev 风格通道调用如下的决策方法:
result = engine.decide(request)

answer = result["answers"]["decision"]

choice = answer["choice"]

probabilities = answer["probabilities"]在 decide() 方法内部,SGLang 通过 /v1/score 接收提示词。请求包含 A、B 和 C 的词元 ID。
SGLang 运行该提示词,读取这三个下一词元的分数,将其归一化,然后停止。响应不包含生成的词元。
标准通道在同一个引擎上调用生成方法:
result = engine.generate_response(
    case["state"],
    case["question"],
    list(case["criteria"].items()),
    max_tokens=32,
)该方法将相同的状态、问题和选项发送到 /v1/chat/completions。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
这是作者所述的决策转换流程;最终分类仍受模型输出和映射设置影响。 这是代码前的操作说明。 仅为代码语言标记。 代码使用最大概率作为决策规则,但没有自行设置置信度阈值;代码未在此处执行。 这是运行提示,不代表脚本已在当前环境执行。 仅为数据格式标记。 这是作者标注为运行后的示例输出;其数值和决策依赖具体提示词、模型及配置。 这是作者对该流程的描述,未提供性能或内部实现的独立核验。 0.70 是示例中的策略要求,不是普遍适用的标准;阈值需要通过带标签数据评估确定。 标题只说明比较主题,尚未给出测量结果。 作者声称构建了测试应用,但本段尚未提供应用代码、测量方法或结果。 这些是作者对部署演示所支持模型的陈述;原文未提供逐一核验信息。 这是作者对实现方式的描述;原文未说明该方法的完整内部实现。 仅为语言标记。 代码展示了字段访问路径,但未在此处说明 result 的完整结构或方法的具体实现。 这是作者对请求内容的描述;原文未给出具体词元 ID 或完整请求格式。 原文声称响应不含生成词元;未说明归一化公式或分数的具体含义。 这是对调用方式的概述;原文未在此处说明生成方法的内部细节。 代码展示了调用参数;原文未说明这些参数在方法内部的全部处理过程。 原文只说明发送到该接口,未说明请求载荷的完整格式。
解释
本块首次出现的知识点
转换为决策
本步骤把模型返回的标签分数重新映射为可读的分类名称,并选择概率最高的结果。
本文语境解释,未作为独立知识专题收录。
完成标签映射
作者准备使用一段代码把标签名称与分数配对,并生成最终决策。
本文语境解释,未作为独立知识专题收录。
Python 代码
该单元标识后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
生成最终决策
代码将 choices 中的标签与 scores 中的分数严格配对,构造 probabilities 字典,再取概率最大的标签作为 decision,最后以 JSON 格式打印决策和概率。
本文语境解释,未作为独立知识专题收录。
运行脚本
作者建议在另一个终端启动前面构建的决策脚本,以查看输出。
本文语境解释,未作为独立知识专题收录。
JSON 输出
该单元标识后续内容是 JSON 格式的输出示例。
本文语境解释,未作为独立知识专题收录。
决策输出示例
代码块展示脚本运行后的示例结果:决策为 billing and payments,三个类别分别得到给定概率。
本文语境解释,未作为独立知识专题收录。
SGLang 的评分流程
作者概括了评分请求的处理链路:标签先被分词,Qwen 执行一次推理,服务再返回所选标签的概率。
本文语境解释,未作为独立知识专题收录。
概率阈值与审核
作者用 0.70 的假设阈值说明:虽然 billing and payments 是最高概率类别,但置信度不足时可以改为人工审核。
本文语境解释,未作为独立知识专题收录。
比较评分延迟
本节标题表明后续内容将比较评分请求与自回归生成在延迟方面的表现。
本文语境解释,未作为独立知识专题收录。
测试多次决策
作者从单次请求的机制说明扩展到一个小型应用,准备观察该机制在多项决策中的行为。
本文语境解释,未作为独立知识专题收录。
支持的开放模型
作者列出了部署演示可使用的模型及其参数规模,说明该演示并不局限于单一模型。
本文语境解释,未作为独立知识专题收录。
Jev 风格决策
作者开始说明 Jev 风格通道如何调用决策方法,为后续代码和请求流程作铺垫。
本文语境解释,未作为独立知识专题收录。
代码语言
该单元标记后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
读取决策结果
代码调用引擎的 decide 方法处理请求,从结果中的 answers 和 decision 字段读取选择及其概率。
本文语境解释,未作为独立知识专题收录。
决策请求
作者说明了决策方法的请求入口,以及用于比较的三个选项对应的词元 ID。
本文语境解释,未作为独立知识专题收录。
分数归一化
该流程只比较三个候选下一词元的分数并进行归一化,不继续生成文本。
本文语境解释,未作为独立知识专题收录。
标准生成通道
作者将标准通道与 Jev 风格通道进行对照,指出两者使用同一引擎但调用不同方法。
本文语境解释,未作为独立知识专题收录。
代码语言
该单元标记后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
生成回答
代码将案例的状态、问题和标准条目传入生成方法,并把最大生成词元数设为 32。
本文语境解释,未作为独立知识专题收录。
生成请求接口
标准生成方法沿用相同输入内容,但通过聊天补全接口提交请求。
本文语境解释,未作为独立知识专题收录。
本块新增 21 项
英文原文 10
272 词 · 4 张图Qwen generates an answer and short explanation, up to 32 tokens. The application searches the first 100 characters for one allowed choice name. It marks the case correct when that parsed choice matches the stored label.
The video compares our 100% local Jev with a 100% local LLM generator, across some examples:
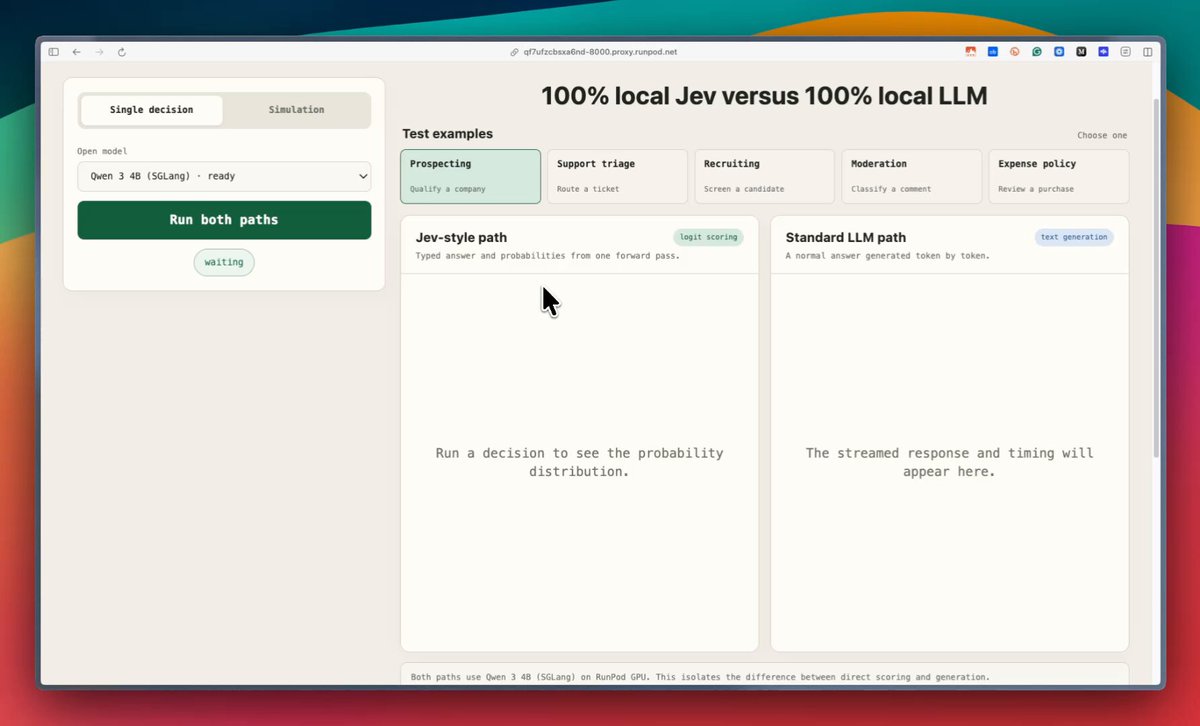
The speed is immediately evident for the reasons we have already discussed above.
Along with this, I also built a simulation of 100 cases from a fixed local dataset.
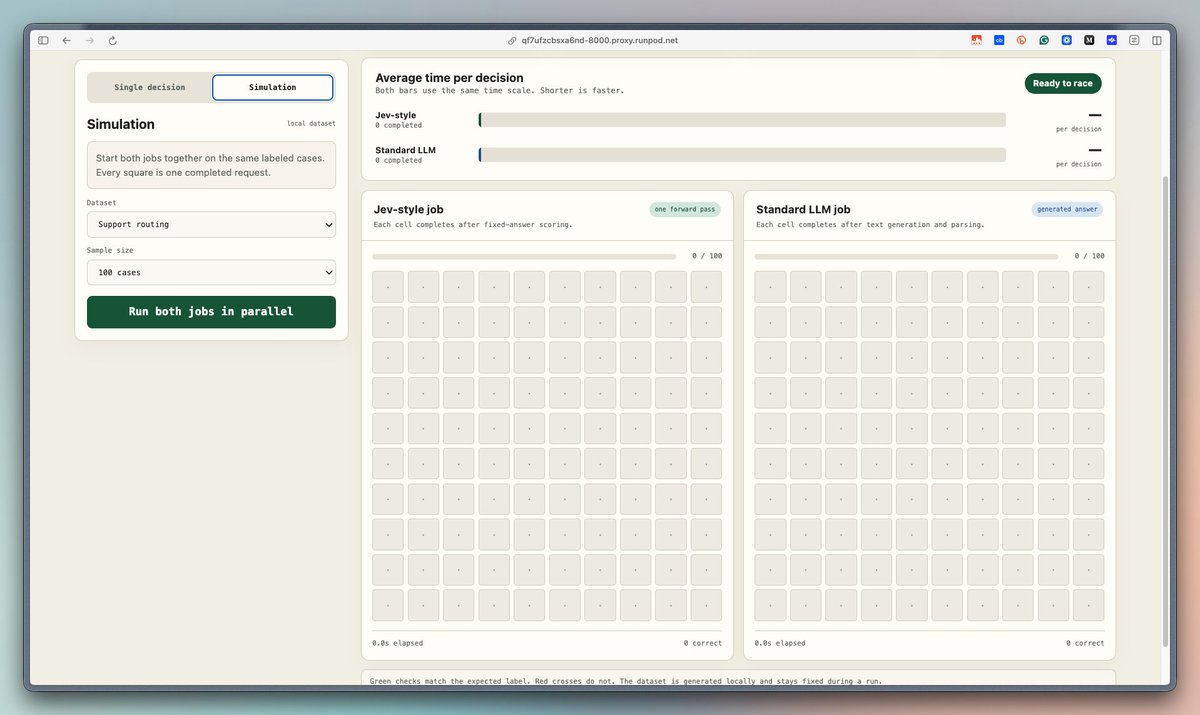
The current datasets cover support routing, candidate screening, and expense review. Their expected labels let the interface display both speed and correctness.
The remote SGLang path starts two workers behind one barrier:
starting_line = threading.Barrier(2)

def worker(lane, runner):
    starting_line.wait()
    for case in cases:
        updates.put(runner(case))

workers = [
    threading.Thread(target=worker, args=("jev", run_jev)),
    threading.Thread(target=worker, args=("llm", run_llm)),
]

for worker_thread in workers:
    worker_thread.start()
The barrier releases both workers together. Each lane processes its own cases in order. The Jev-style worker sends the next scoring request as soon as its previous request finishes. The standard worker does the same with generation requests.
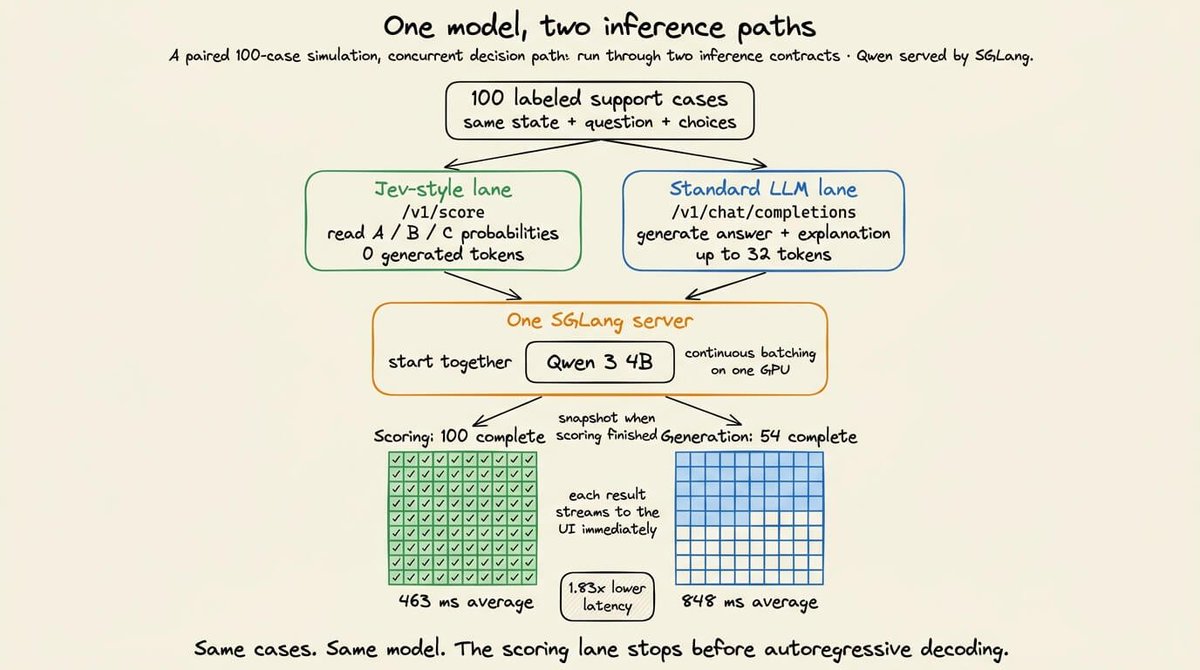
The two lanes therefore remain active at the same time, but we do not send all 200 requests at once. SGLang receives concurrent work from both lanes and schedules it through continuous batching. Both request types share the same GPU, memory bandwidth, and scheduler.
The video below depicts a side-by-side comparison of Jev and an LLM:
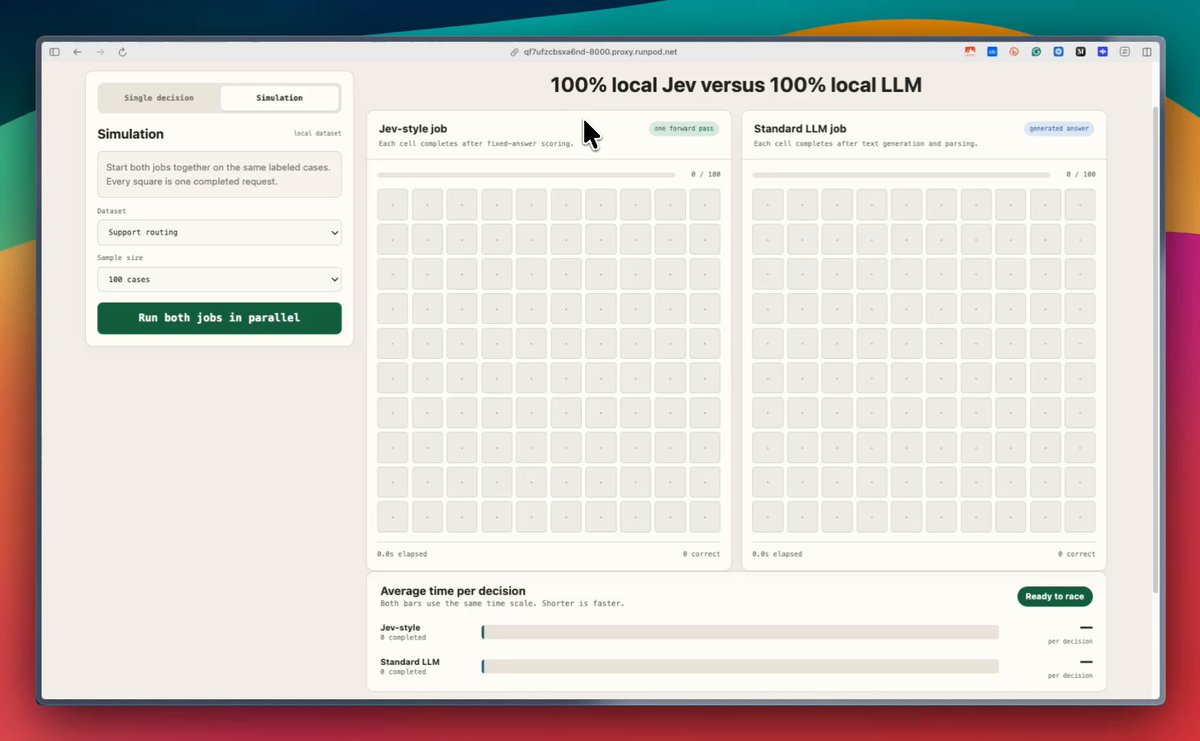 Note: The video was sped up after 8 seconds, which is why LLM requests appear to complete fast.
Both lanes started together and used Qwen/Qwen3-4B-Instruct-2507 on the same SGLang server.
中文译文 10
461 字Qwen 生成回答和简短解释,最多 32 个词元。应用程序在前 100 个字符中搜索一个允许的选项名称。当解析出的选项与存储的标签一致时,应用程序将该案例标记为正确。
视频通过一些示例,将我们的 100% 本地 Jev 与 100% 本地 LLM 生成器进行了比较:
由于我们上文已经讨论过的原因,速度优势是立刻可以看出的。
此外,我还使用一个固定的本地数据集,构建了一个包含 100 个案例的模拟。
当前数据集涵盖支持路由、候选人筛选和费用审核。其预期标签让界面能够同时展示速度和正确性。
远程 SGLang 路径在一个屏障后启动两个工作线程:
starting_line = threading.Barrier(2)

def worker(lane, runner):
    starting_line.wait()
    for case in cases:
        updates.put(runner(case))

workers = [
    threading.Thread(target=worker, args=("jev", run_jev)),
    threading.Thread(target=worker, args=("llm", run_llm)),
]

for worker_thread in workers:
worker_thread.start()屏障会同时释放两个工作线程。每条通道按顺序处理自己的案例。Jev 风格工作线程会在上一个请求完成后立即发送下一个评分请求。标准工作线程对生成请求也采取同样做法。
因此,两条通道会同时保持活动状态,但我们不会一次发送全部 200 个请求。SGLang 接收来自两条通道的并发工作,并通过连续批处理进行调度。两种请求类型共享同一个 GPU、内存带宽和调度器。
下面的视频展示了 Jev 与 LLM 的并排对比:
注意:视频在 8 秒后被加速,这就是 LLM 请求看起来完成得很快的原因。两条通道同时启动,并在同一个 SGLang 服务器上使用 Qwen/Qwen3-4B-Instruct-2507。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
正确性依赖前 100 个字符中的选项名称解析和存储标签;原文未说明未匹配或多重匹配时的处理。 原文未在此处列出示例内容或给出完整比较结果。 这是作者的判断;当前原文片段未重述相关原因,也未提供速度数据。 原文未说明数据集内容、案例构成或模拟结果。 原文只列出任务类别和标签用途,未提供数据集规模以外的统计信息、标签来源或准确率。 这是对并发结构的引入;具体同步和处理逻辑见后续代码与说明。 仅为语言标记。 代码展示了线程启动结构;未展示 cases、updates、run_jev 和 run_llm 的定义或线程结束处理。 原文描述的是作者实现中的调度行为;未说明请求是否在服务端或客户端进一步排队。 原文声称两类请求共享这些资源;未提供吞吐量、延迟或资源占用数据。 当前原文未包含视频画面或具体对比结果。 这是作者对视频呈现方式的说明;未给出实际加速倍数。 原文未说明服务器硬件、配置或测试案例细节,因此无法仅据此判断比较结果的普适性。
解释
本块首次出现的知识点
解析生成结果
作者描述了标准通道如何限制输出长度、从输出开头识别选项,并依据识别结果与标签的匹配情况判断正确性。
本文语境解释,未作为独立知识专题收录。
本地方案对比
作者引出视频中的对比,比较两种都在本地运行的决策或生成方案。
本文语境解释,未作为独立知识专题收录。
速度差异
作者认为两种方案的速度差异在对比中很明显,并将原因归于前文已经讨论的内容。
本文语境解释,未作为独立知识专题收录。
百案例模拟
作者补充说明使用固定本地数据集进行模拟,以便在统一案例集合上比较方案。
本文语境解释,未作为独立知识专题收录。
数据集与评估
这些数据集包含三类任务,并通过预先设定的标签同时支持速度和正确性展示。
本文语境解释,未作为独立知识专题收录。
并行工作线程
作者开始说明远程 SGLang 路径如何让两个工作线程同步启动,以便并行比较两条处理通道。
本文语境解释,未作为独立知识专题收录。
代码语言
该单元标记后续代码使用 Python。
本文语境解释,未作为独立知识专题收录。
启动并行线程
代码创建一个需要两个参与者的线程屏障,定义工作函数,并分别为 Jev 和 LLM 通道创建及启动线程。
本文语境解释,未作为独立知识专题收录。
两条通道同步处理
两个线程从同一同步点开始,但各自按顺序推进;下一请求要等本通道的前一请求完成。
本文语境解释,未作为独立知识专题收录。
连续批处理
作者区分了两条通道并行运行与一次性提交全部请求:请求会并发到达 SGLang,再由连续批处理共享硬件资源进行调度。
本文语境解释,未作为独立知识专题收录。
视频对比
作者引导读者观看视频,以并排形式观察两种方案的运行差异。
本文语境解释,未作为独立知识专题收录。
视频加速说明
作者提醒观看者,视频后段经过加速,因此画面中的 LLM 请求速度不能直接按播放时间理解。
本文语境解释,未作为独立知识专题收录。
相同测试环境
作者说明对比时让两条通道共享启动时间、服务器和具体模型,以保持测试环境一致。
本文语境解释,未作为独立知识专题收录。
本块新增 13 项
英文原文 11
237 词 · 1 张图How to choose the right approach
Scoring is not a replacement for generation, so Jev's approach only applies when the application defines the output space before inference.
A compatible workload ideally should have a finite set of meaningful labels. Each label should map to a distinct downstream action.
And the caller must only need a label and its probability distribution, not new text.
Structured output is different since it defines the syntax of a response, and the decoder still generates field names and values token by token.
Use structured generation when those values cannot be enumerated beforehand, since scoring removes decoding only when the candidate values are already known.
This graphic compares regular LLM decoding, structured output decoding, and Jev-style scoring:
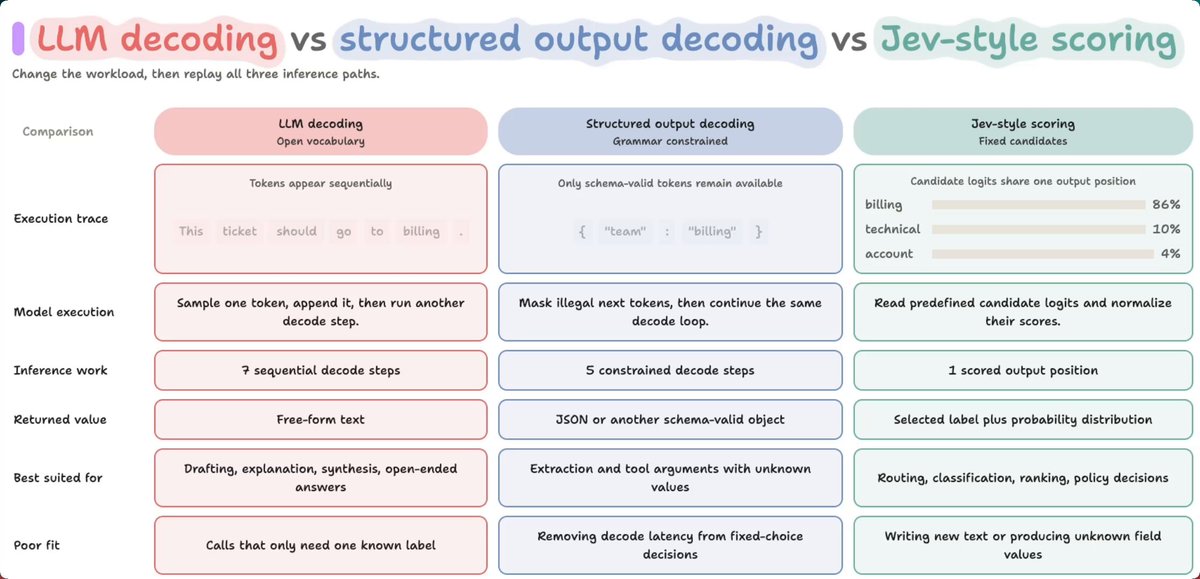
One good way to proceed is to choose the inference path from the required output:
- Generate when the output content is unknown before inference.
- Score when the output set is known, and selection is sufficient. In that case, the first next-token vector already contains the ranking. Returning that ranking avoids an autoregressive loop the caller does not need.
To reiterate, this article project reproduces the Jev-style inference mechanism, but it does not reproduce Jev's weights, RLCD process, or evaluation stack.
I intend to cover the processes behind those pretty soon.
Stay tuned!
That's a wrap!
If you enjoyed this tutorial:
Find me → @_avichawla
Every day, I share tutorials and insights on DS, ML, LLMs, and RAGs.
中文译文 11
439 字如何选择合适的方法
评分并不能替代生成,因此 Jev 的方法只适用于应用在推理前就定义了输出空间的情况。
理想情况下,兼容的工作负载应具有一组有限且有意义的标签。每个标签都应对应一个不同的下游操作。
并且,调用方只需要标签及其概率分布,而不需要新生成的文本。
结构化输出有所不同,因为它定义的是响应的语法,而解码器仍然会逐个 token 地生成字段名和值。
当这些值无法预先枚举时,应使用结构化生成,因为只有在候选值已经已知的情况下,评分才会移除解码过程。
这张图比较了常规 LLM 解码、结构化输出解码和 Jev 风格的评分:
一种有效的做法是根据所需的输出选择推理路径:
- 当输出内容在推理前未知时,进行生成。
- 当输出集合已知且进行选择就足够时,进行评分。在这种情况下,第一个下一 token 向量已经包含了排序结果。返回该排序可以避免调用方并不需要的自回归循环。
再次强调,这个文章项目复现的是 Jev 风格的推理机制,但并不复现 Jev 的权重、RLCD 流程或评估栈。
我打算很快介绍这些流程背后的过程。
敬请期待!
到这里就结束了!
如果你喜欢这篇教程:
找到我 → @_avichawla [1]
我每天都会分享有关数据科学、机器学习、大型语言模型和检索增强生成的教程与见解。
上下游
本块首次出现的来源与延伸
本块相关内容已在前文介绍
判断
对本块内容的判断
标题本身未提供选择标准或结论。 这是作者对方法适用范围的限定;未说明所有此类应用都一定适合该方法。 这是作者提出的理想条件;原文没有说明标签数量或下游操作的具体标准。 这是作者对适用调用模式的描述;未涵盖同时需要标签和文本的场景。 这是作者对结构化输出机制的概括;原文没有进一步讨论具体语法约束实现。 这是作者给出的选择原则;“移除解码”指该评分流程中的解码步骤,不代表所有结构化生成都可被评分替代。 原文仅说明图片的比较对象;给定资料中未包含图片内容,因此无法补充图中的具体信息。 这是作者的实践建议;原文未声称该选择规则适用于所有推理任务。 这是作者给出的简化决策规则;未讨论部分已知、部分未知的混合情况。 这是作者对 Jev 风格评分效率和输出形式的判断;原文没有提供性能数字,也没有说明该排序在所有模型或任务中都同样有效。 这是作者对项目边界的明确声明;因此不能据此认为该项目复现了 Jev 的完整系统或结果。 这是作者的计划性表述,不是对后续内容已经发布或完成的确认。 这是宣传性结束语,不包含可核验的技术信息。 这是篇章结束语,不表达额外的技术判断。 原文在此处使用冒号引出后续内容;给定单元本身没有提出具体行动要求。 这是原文提供的作者账号信息;给定资料仅包含该账号链接,未对账号内容作出核验或说明。 这是作者对自身发布内容频率和主题的自述;原文未提供独立核验信息。
解释
本块首次出现的知识点
选择合适的方法
这是下一部分的标题,表明作者将转向讨论不同方法的选择。
本文语境解释,未作为独立知识专题收录。
评分的适用前提
作者区分了评分与生成,并指出只有当输出候选空间预先确定时,Jev 方法才适用。
本文语境解释,未作为独立知识专题收录。
有限的标签集合
该方法面向标签选择任务:候选标签数量有限,而且不同标签会触发不同的后续动作。
本文语境解释,未作为独立知识专题收录。
调用方所需的输出
作者进一步限定了调用方的需求:结果应是标签和概率分布,而不是一段新文本。
本文语境解释,未作为独立知识专题收录。
结构化输出的区别
结构化生成约束响应的格式,但字段名和值仍需通过逐 token 解码生成,因此不等同于只对已知候选进行评分。
本文语境解释,未作为独立知识专题收录。
何时使用结构化生成
作者将方法选择与候选值是否预先已知联系起来:未知值需要生成,已知候选值则可以通过评分避免解码。
本文语境解释,未作为独立知识专题收录。
三种推理方式的比较
作者引出一张用于对比三种处理路径的图:常规语言模型解码、结构化输出解码,以及 Jev 风格评分。
本文语境解释,未作为独立知识专题收录。
根据输出选择路径
作者建议先判断所需输出的性质,再决定采用生成还是评分等推理方式。
本文语境解释,未作为独立知识专题收录。
未知内容使用生成
如果事先不知道需要产生的具体内容,就必须让模型生成输出。
本文语境解释,未作为独立知识专题收录。
已知集合使用评分
对于预先知道候选集合、只需从中选择的任务,作者认为第一次下一 token 的向量就能提供候选排序,因此无需继续逐步生成。
本文语境解释,未作为独立知识专题收录。
复现范围的限制
作者明确区分了项目复现的内容与未复现的内容:项目只涉及 Jev 风格的推理机制,不包括模型权重、RLCD 流程或评估工具链。
本文语境解释,未作为独立知识专题收录。
后续介绍计划
作者表示计划在之后介绍前文提到的权重、RLCD 流程和评估栈背后的过程。
本文语境解释,未作为独立知识专题收录。
敬请期待
作者以简短的结束语提示读者关注后续内容。
本文语境解释,未作为独立知识专题收录。
文章结束
作者宣布本篇文章或教程部分结束。
本文语境解释,未作为独立知识专题收录。
教程反馈引导
作者开始引导喜欢本教程的读者进行后续互动。
本文语境解释,未作为独立知识专题收录。
作者账号
作者提供了自己的账号 @_avichawla,供读者查找。
本文语境解释,未作为独立知识专题收录。
作者分享内容
作者介绍其日常分享主题,包括 DS(数据科学)、ML(机器学习)、LLMs(大型语言模型)和 RAGs(检索增强生成)。
本文语境解释,未作为独立知识专题收录。
本块新增 17 项
来源与阅读说明
正文取自用户提交的本地文件,原始文件与原图按字节归档。原网页含 4 段视频,本保存件未取得视频文件;保留静态预览(如有),完整视频请从原文链接查看。中文译文逐单元生成并由另一次模型请求审校;未进行人工全文审校、线上来源比对或代码执行。作者与日期缺失时保留未知。
阅读补充解释本文内容与限制,不冒充独立知识专题或外部事实核验。图片保持原样,图内说明单独保存。阅读器沿用 ReadLess 公共组件及中文约 400 字分块规则。